Seguridad · Infraestructura de IA · Riesgo de Proveedor
Fuga de Datos en Inferencia de IA: 155 No Es el Dato
Cloudflare filtró 155 respuestas de IA entre clientes. El bug no deja línea de log, así que ningún proveedor puede auditar la exposición.
Cloudflare comunicó que 155 respuestas de su plataforma Workers AI volvieron con fragmentos de prompts y generaciones parciales de otros clientes. La cifra es pequeña, es precisa, y es el dato menos útil de toda la divulgación — porque el defecto que la produjo no genera error y no escribe ninguna línea de log. 155 es la cantidad de fugas que Cloudflare pudo deducir a partir de la forma de sus peticiones, no la cantidad que ocurrió. Para esta clase de fallo, ningún proveedor de inferencia alojada puede decirte después de los hechos si tus prompts acabaron dentro de la respuesta de otra persona.
Si revendes una funcionalidad de IA, tú eres el responsable del tratamiento frente a tu cliente final. El RGPD te da 72 horas para notificar una brecha, y una notificación necesita evidencia — que es exactamente lo que este fallo no deja. Esa es la frase que conviene llevar a la próxima conversación con el proveedor, y tiene muy poco que ver con la competencia de Cloudflare.
Qué está verificado aquí y qué es la palabra del proveedor
Este texto se apoya en dos tipos de afirmación, y mezclarlos lo haría menos útil.
Verificado de forma independiente, contra la API de GitHub y el propio comunicado de seguridad de los mantenedores del motor: las fechas, el reporte público del bug siete semanas antes del lanzamiento, el historial de versiones y la afirmación de que la corrupción no deja rastro. Eso es registro público, y lo leímos nosotros mismos el 27 de octubre de 2026.
Reportado por Cloudflare sobre Cloudflare, sin que ninguna parte externa pueda confirmarlo ni acotarlo: la cifra de 155; que toda petición afectada llevaba un prompt de más de 681.280 tokens; que ningún otro modelo de Workers AI resultó afectado; que no hay "evidencia de explotación deliberada"; y la cronología de la respuesta al incidente. Cloudflare es la única parte que tiene esos logs. Y por el mecanismo descrito en el propio post de Cloudflare, esos logs no pueden mostrar la fuga directamente — así que 155 es un suelo deducido de la forma de las peticiones, no una medición. Leer esa cifra como techo es el error del que trata este post.
Decirlo no es un reproche a la divulgación. El post de Cloudflare es inusualmente franco, incluso sobre sus propias pruebas. Es una afirmación sobre qué evidencia existe.
La firma del fallo: todas las luces estaban en verde
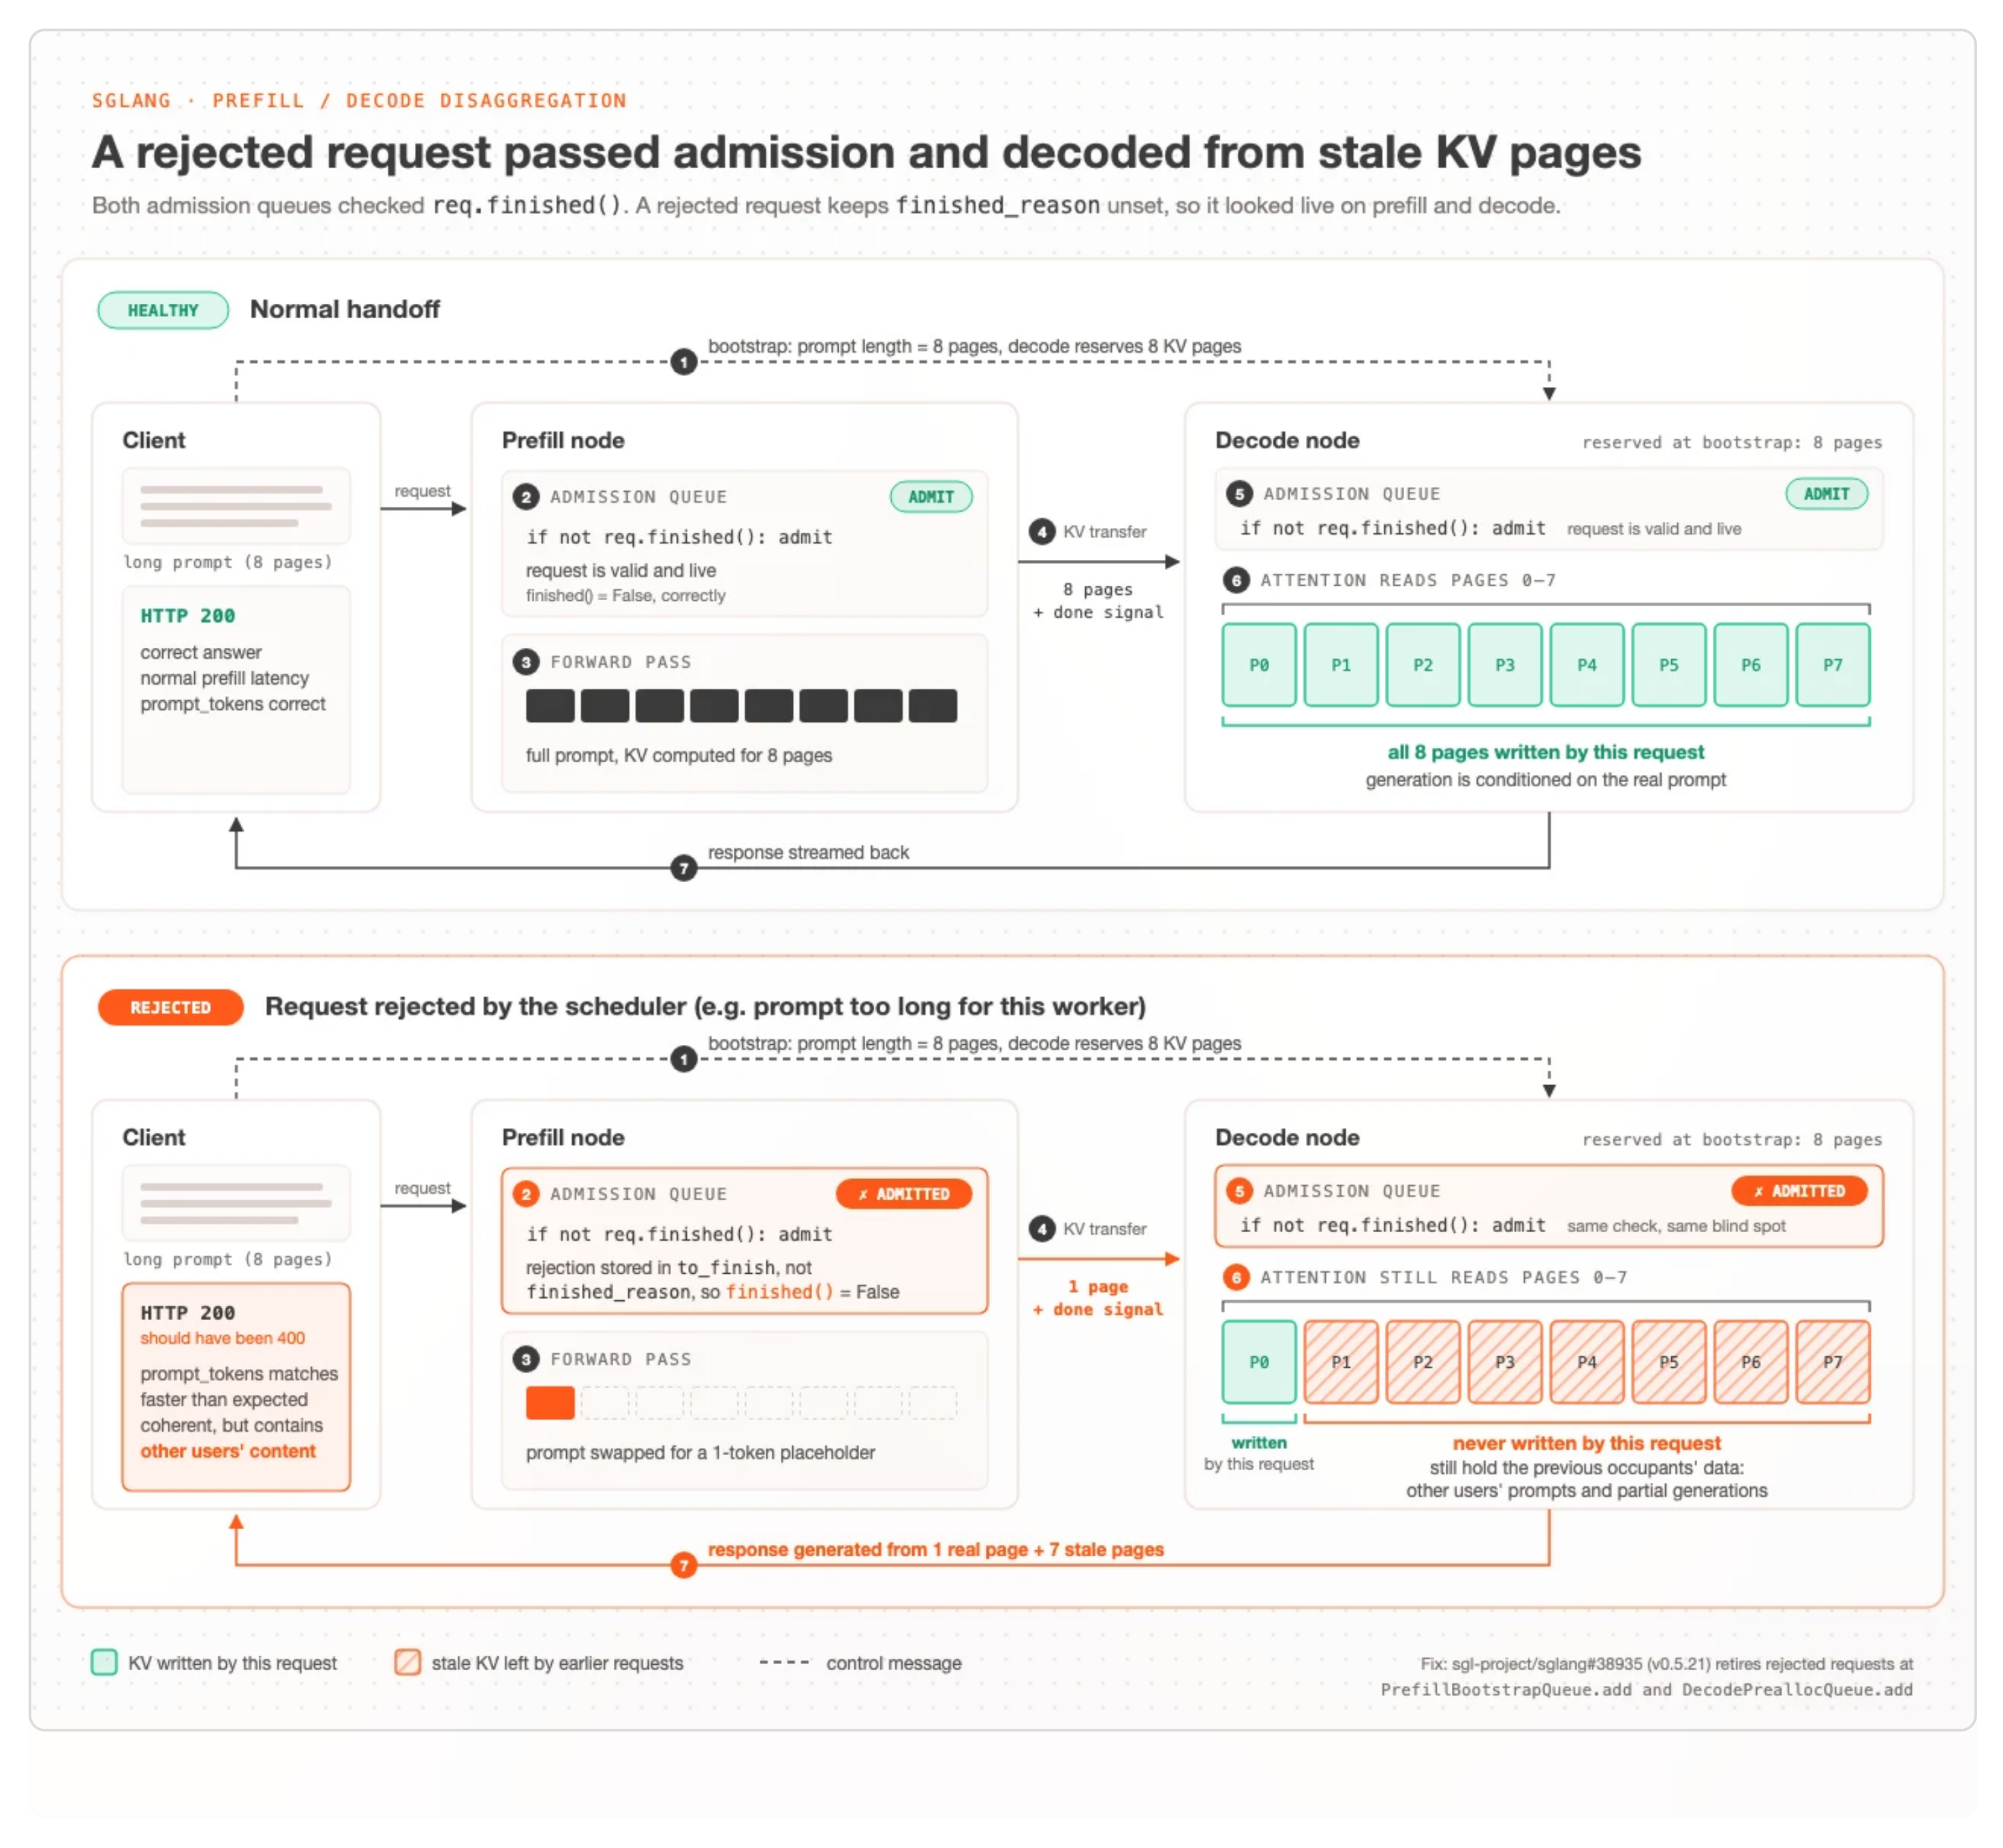
El modelo era @cf/zai-org/glm-5.3, servido con prefill y decode repartidos en nodos distintos — el nodo de prefill calcula la caché clave-valor del prompt, la envía por red, y el nodo de decode genera a partir de ella. Una petición con un prompt demasiado largo para el worker de prefill fue rechazada por el planificador. El rechazo se guardó en el campo equivocado, así que las dos colas de admisión consultaron req.finished(), vieron False y la dejaron pasar como si siguiera viva.
El nodo de prefill cambió entonces el prompt por un marcador de un solo token y transfirió una única página de caché. El nodo de decode ya había reservado ocho. La atención leyó las ocho igualmente. Siete de ellas todavía guardaban lo que habían dejado sus ocupantes anteriores: prompts y generaciones parciales de otros clientes.
Lo que recibió el cliente fue un HTTP 200 que debería haber sido un 400, un recuento de prompt_tokens que coincidía con el prompt real, latencia mejor de la esperada, y una respuesta coherente y bien formada.
El diagrama de la propia Cloudflare. La petición rechazada supera ambas colas, se escribe una página real y la atención lee las ocho. El cliente recibe HTTP 200 y una respuesta fluida montada con siete páginas de datos ajenos. Fuente: Cloudflare.
Esta es la parte que la cobertura repitió sin desarrollar. En un sistema CRUD normal, leer memoria no inicializada produce un cierre inesperado, un nulo, una traza — algo que una aserción detecta. En un modelo de lenguaje, una lectura corrupta produce texto fluido, porque el decodificador continúa tan tranquilo a partir de los bytes que haya en la ventana de atención. El fallo no se anuncia. Se renderiza.
Por qué pasaron las pruebas
Cloudflare declara la laguna con sus propias palabras, y es la frase más aprovechable del post (traducción nuestra):
Esta fue una laguna crítica en nuestras pruebas: solo validamos códigos de respuesta HTTP y el rendimiento del motor en contextos largos, sin validar la salida y la coherencia del modelo.
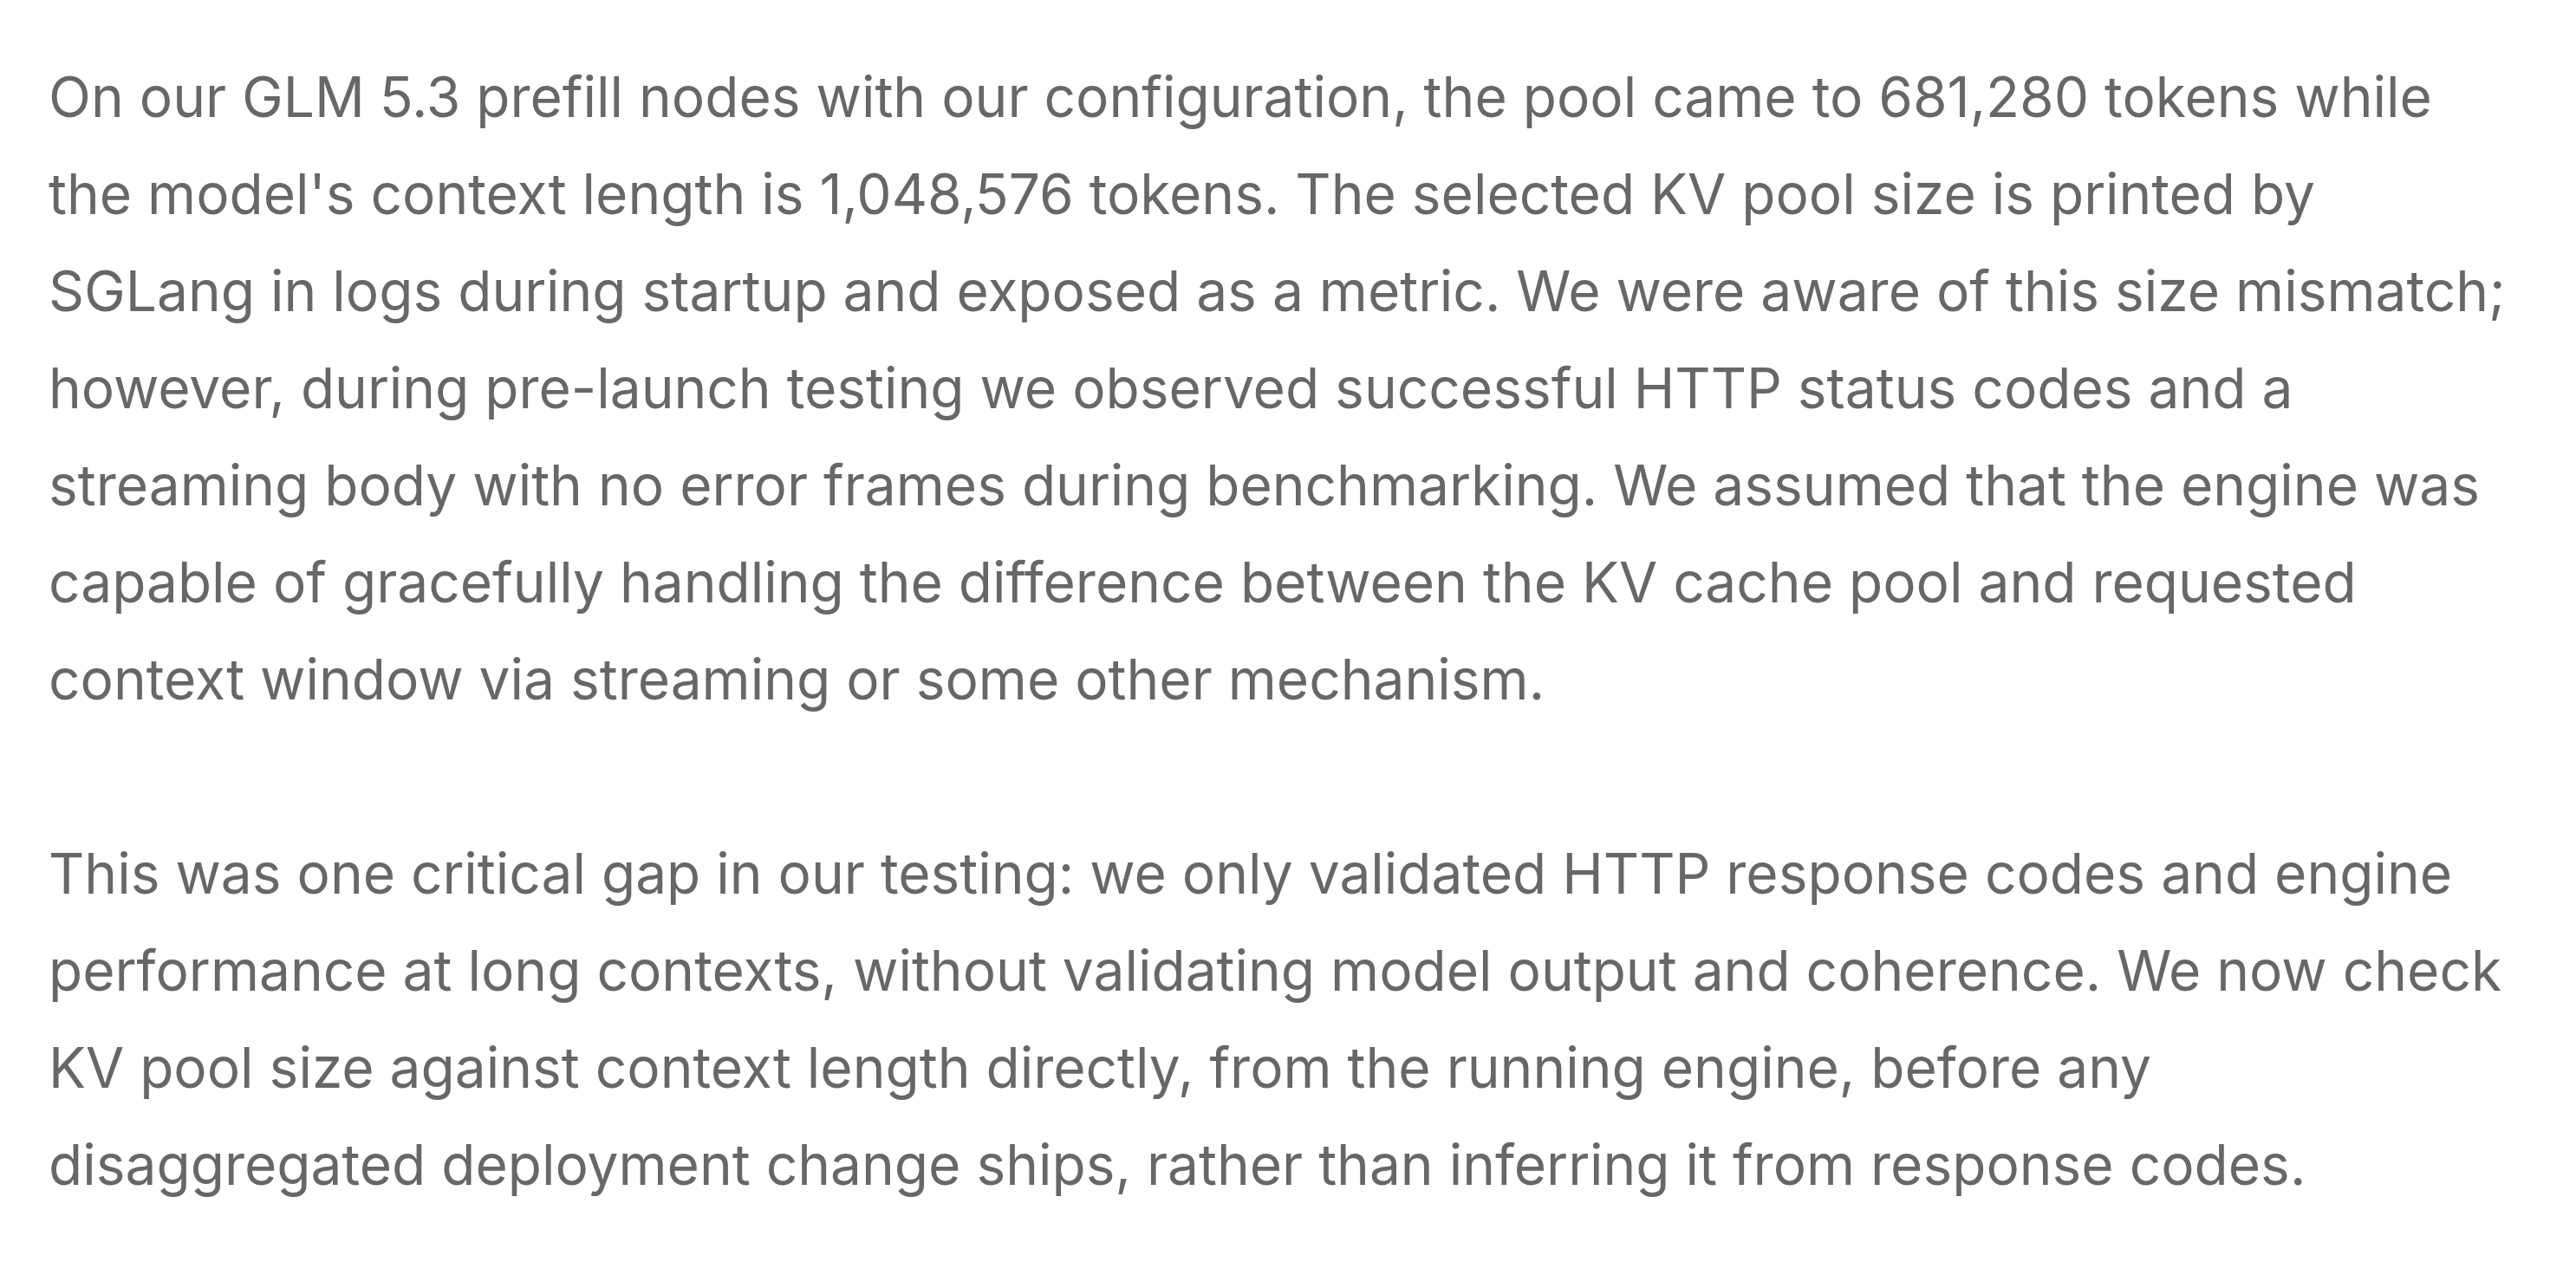
La admisión que convierte esto en un problema de todos y no de Cloudflare. El equipo sabía que el pool de caché era menor que la ventana de contexto anunciada y lanzó igual, porque las pruebas salieron en verde — y las pruebas afirmaban sobre códigos de estado. Fuente: Cloudflare.
Léelo como lección de diseño, no como confesión. Las pruebas de aceptación basadas en código de estado y smoke test son adecuadas para una API REST. Frente a un motor de inferencia son estructuralmente ciegas, porque el modo de fallo del sistema es un 200 con buena prosa. La ceguera es una propiedad de la arquitectura, no del esmero de nadie — y justo por eso tus pruebas también la tienen.
El bug era público siete semanas antes del lanzamiento
Aquí está la parte que nadie más comprobó. El defecto exacto se registró en GitHub como sgl-project/sglang#30233 el 6 de julio de 2026 — 52 días antes de que Cloudflare lanzara GLM 5.3 en Workers AI, el 27 de agosto. No es una queja vaga: nombra set_finish_with_abort, el truncado a un token y el lado de decode leyendo slots de caché sin inicializar, en seis pasos, con un parche funcional y una receta de reproducción. Su bloque de entorno lista la misma familia de modelo, el mismo backend de transferencia y el mismo contexto de un millón de tokens que el despliegue de Cloudflare.
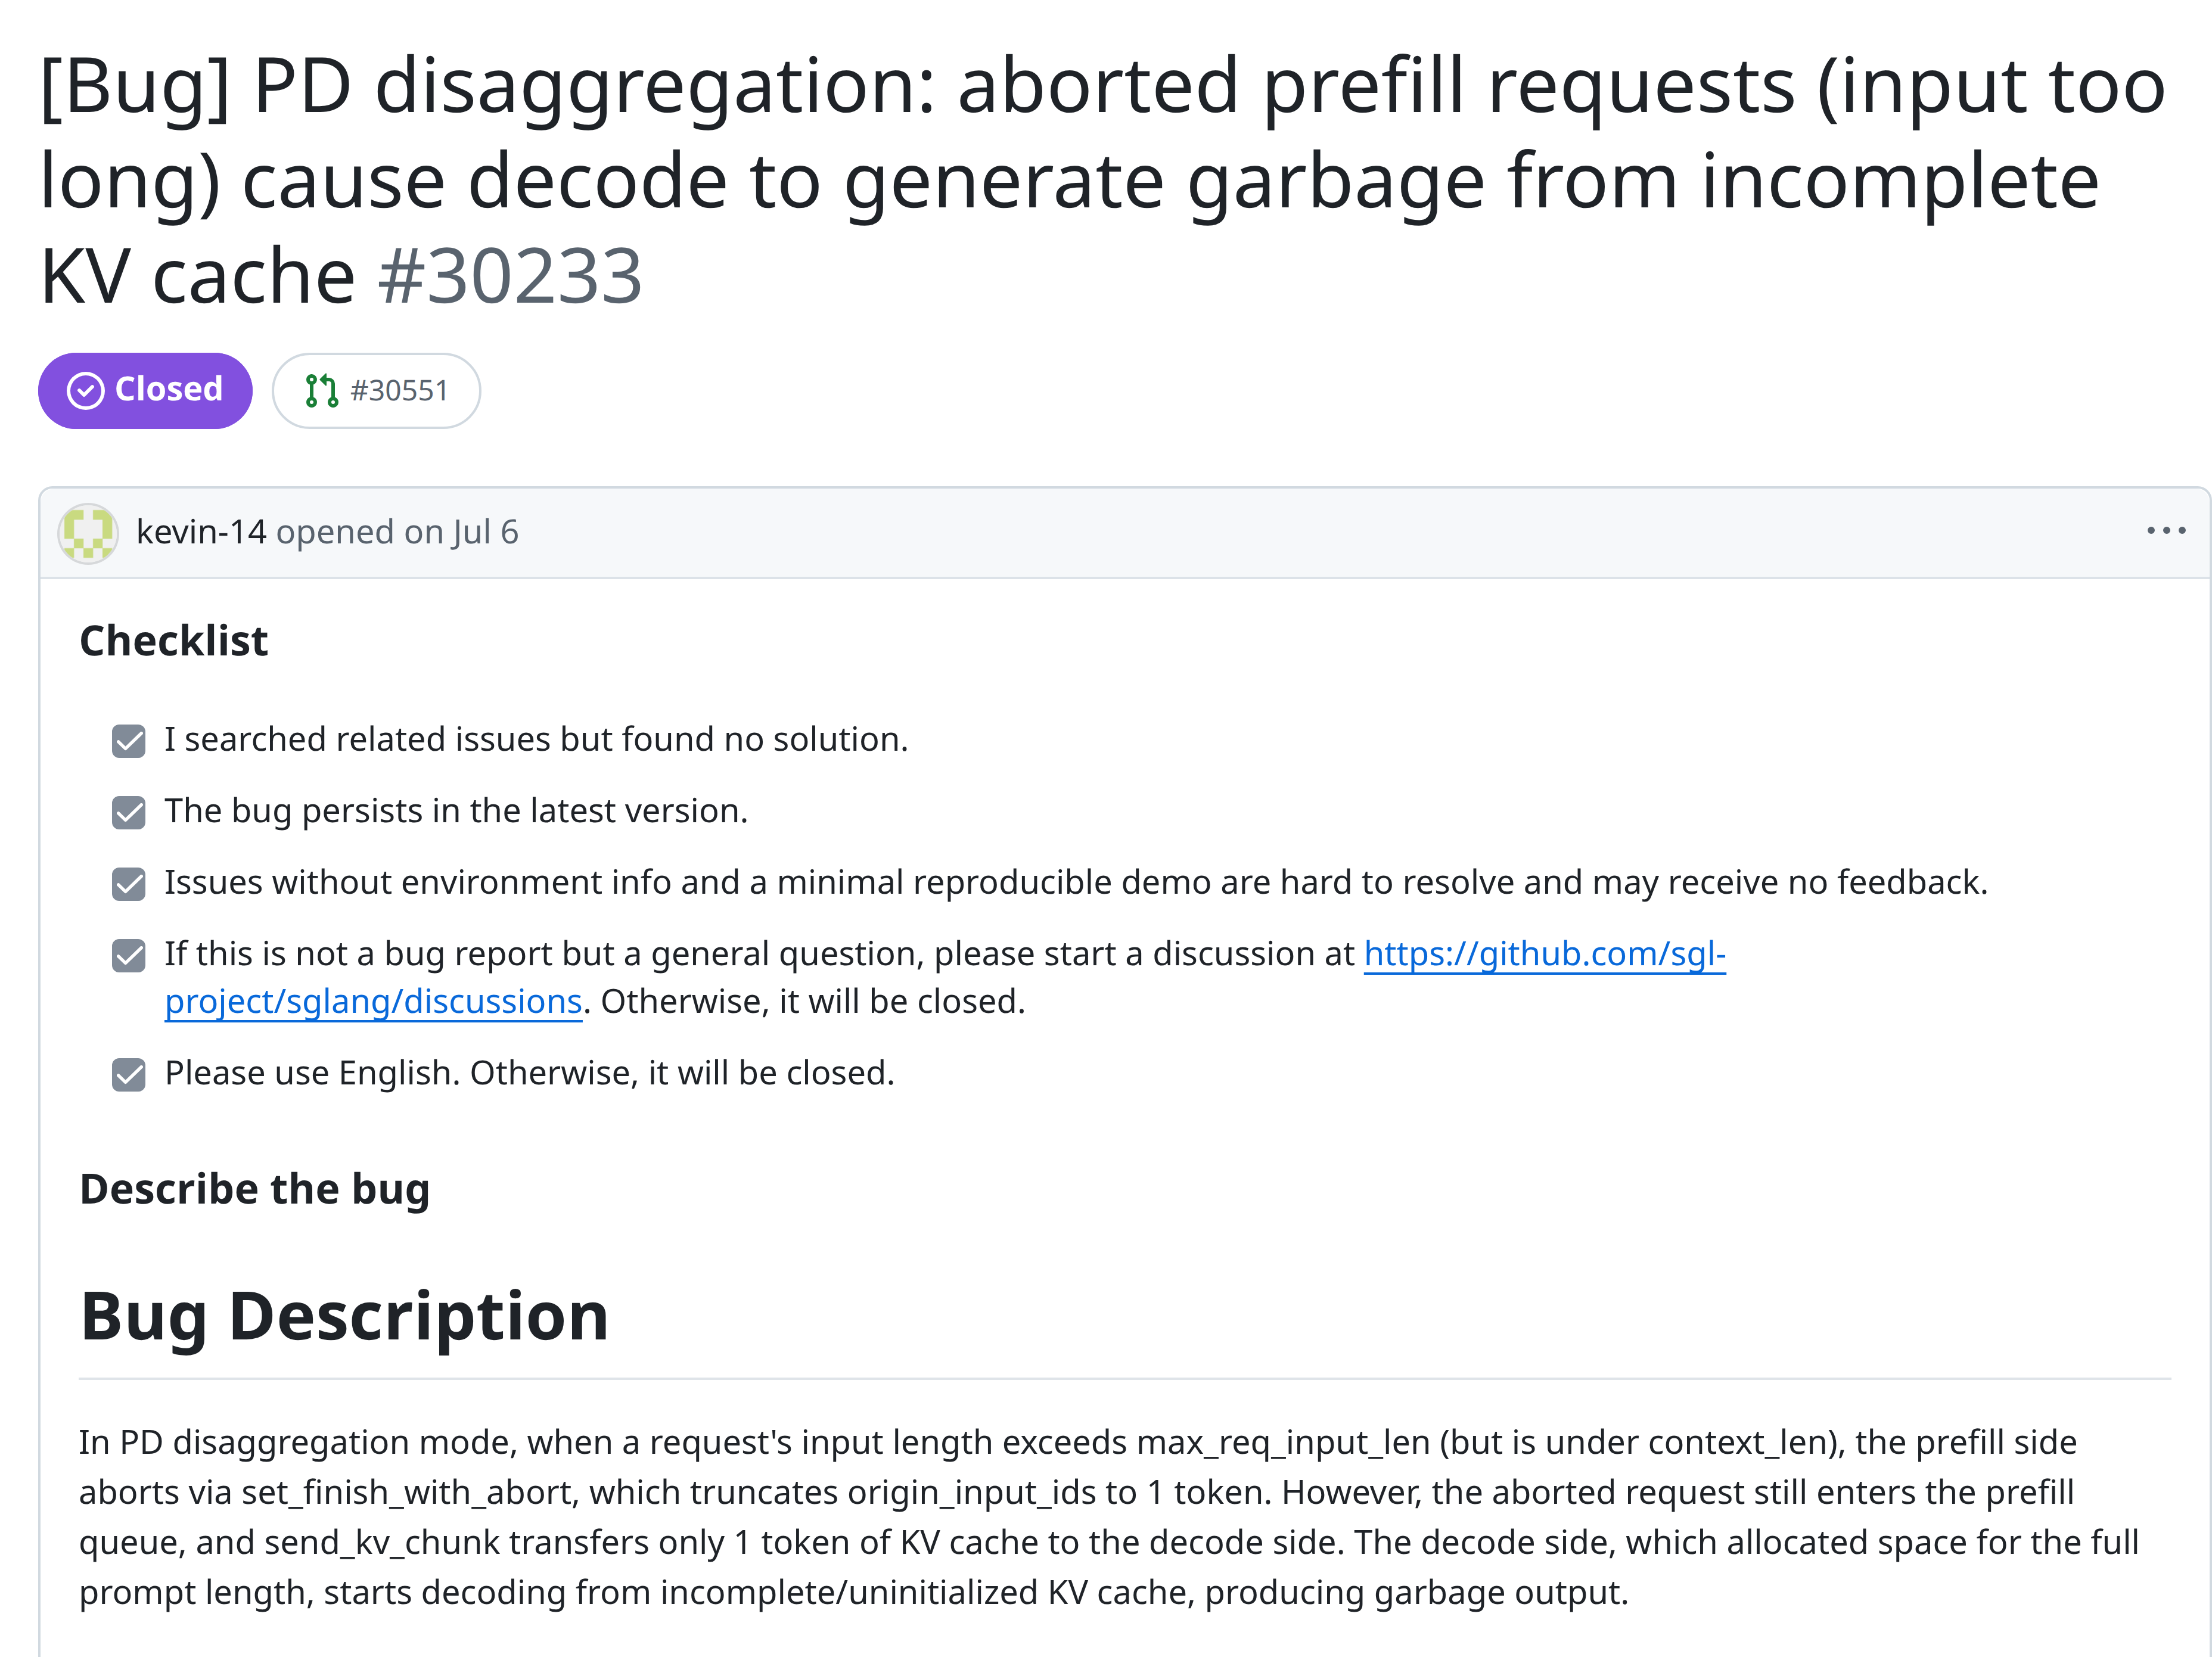
Issue #30233, 6 de julio de 2026. La causa raíz está completa y es correcta. El síntoma se registró como salida basura — las mismas páginas de caché sin inicializar que Cloudflare tendría después que reportar como datos de otros clientes. Fuente: github.com/sgl-project/sglang.
El título lo llama "garbage output", salida basura. Las palabras fuga, tenant y seguridad no aparecen por ningún lado. El paso cuatro de la reproducción dice: "decode devuelve contenido basura no relacionado con la entrada."
La misma memoria sin inicializar. Dos lectores. Uno registró un defecto de calidad; el otro tuvo que declarar una brecha de datos. La gravedad la decidió quién leyó el síntoma, no el bug.
Y la issue no se cerró con una corrección. Un bot de inactividad la cerró como completed y le puso la etiqueta inactive el 4 de septiembre — cuatro días antes de que el reporte de seguridad del investigador Gadi Evron, de Knostic, llegara a Cloudflare vía HackerOne, el 8 de septiembre.
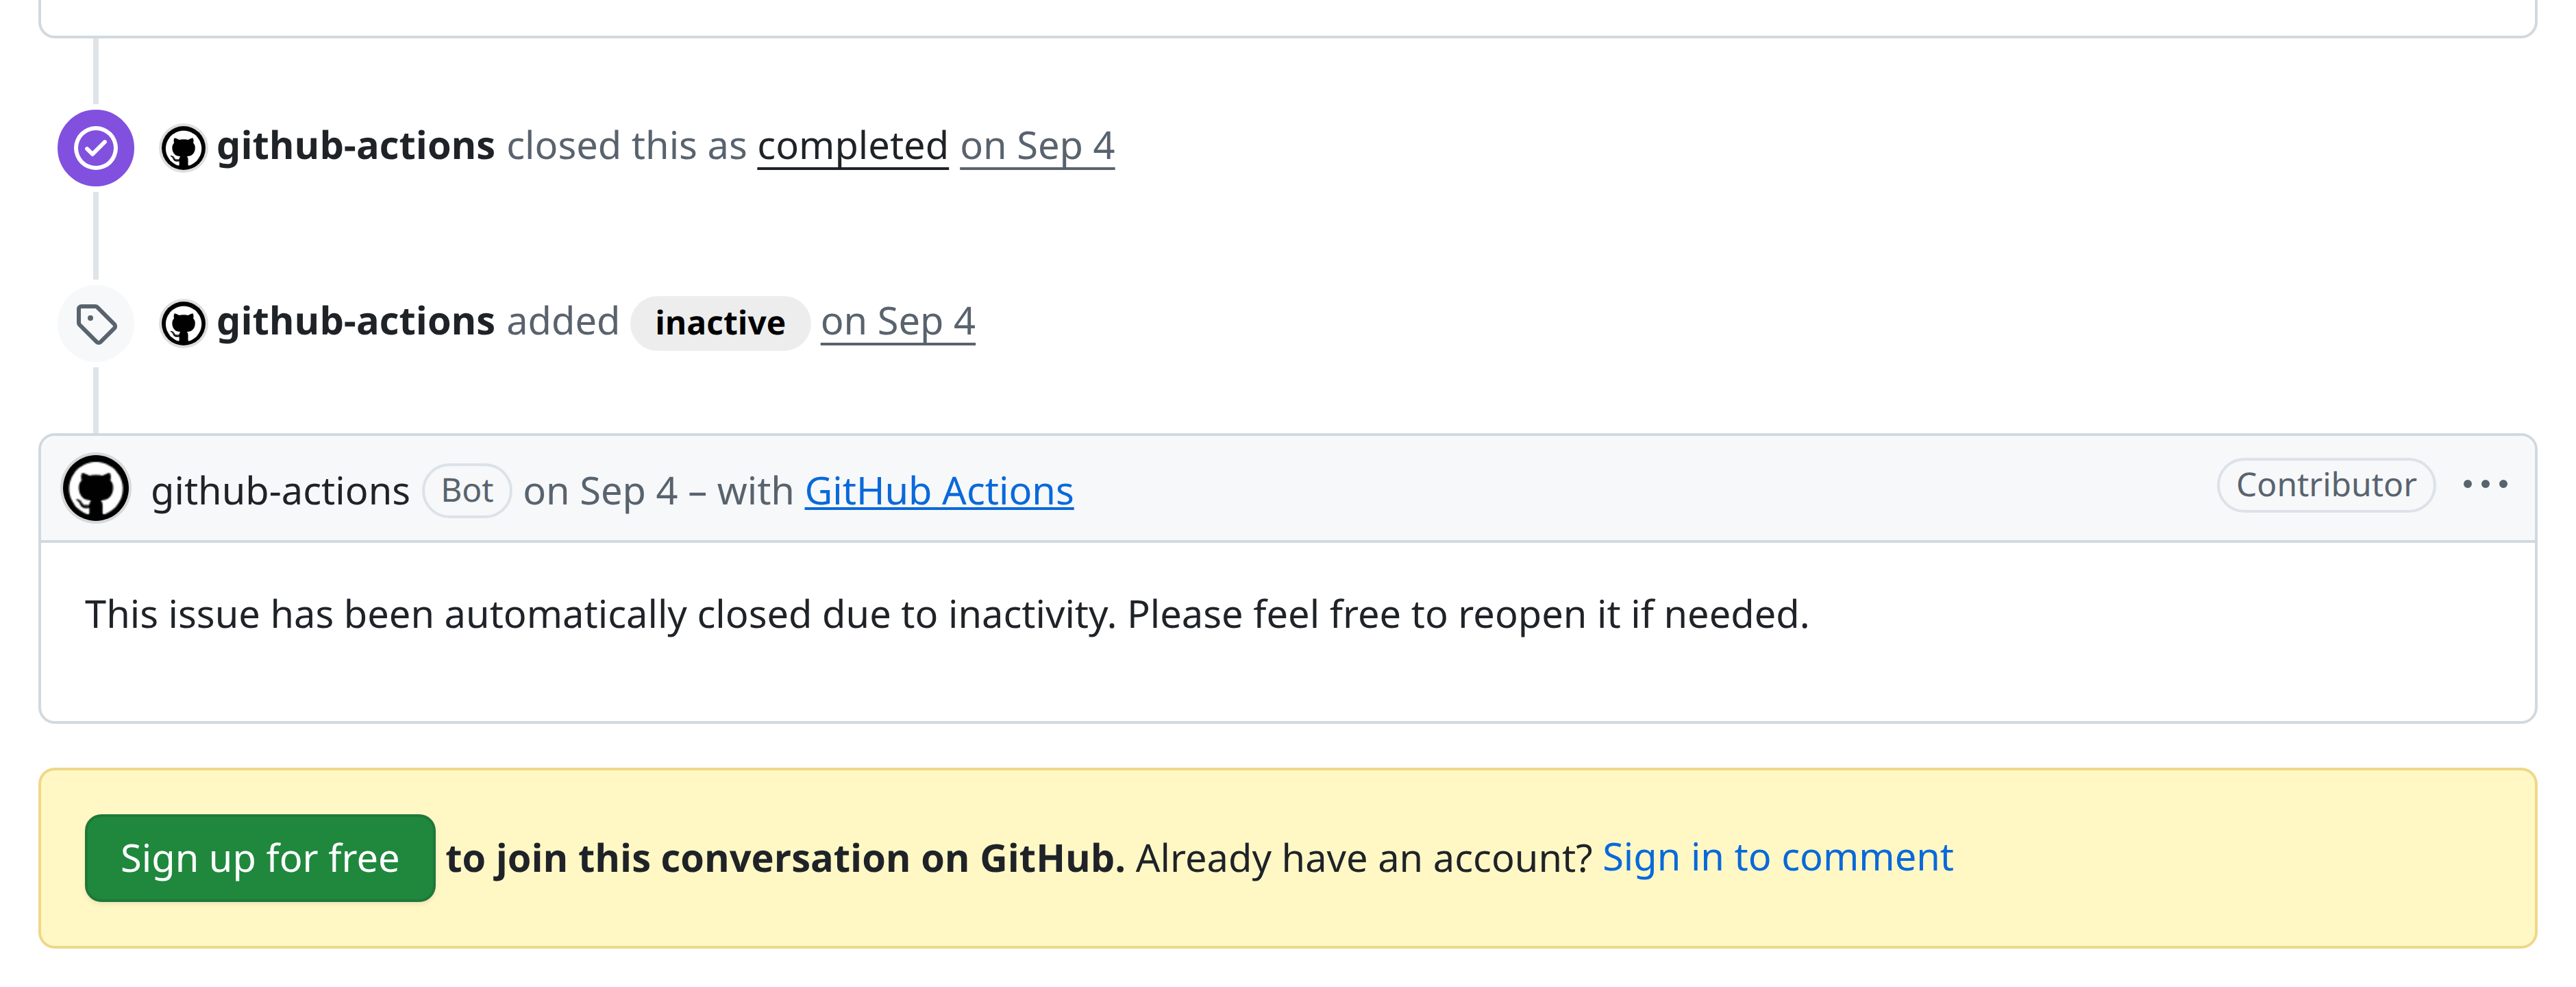
Ningún humano la cerró. Un bot de inactividad marcó como completado el reporte público de este bug el 4 de septiembre; el reporte de seguridad llegó el 8 de septiembre. Fuente: github.com/sgl-project/sglang.
Las dos cifras que pesan más que 155
Los mantenedores del motor publicaron un comunicado coordinado junto al de Cloudflare. Sobre la condición de carrera relacionada, la de transferencia abortada — misma firma, distinto disparador — afirma que, en despliegues desagregados, las configuraciones por defecto estuvieron afectadas desde la línea v0.4.x a principios de 2025 hasta la v0.5.21, el 2 de octubre de 2026. Más de dieciocho meses, activo por defecto, en todo el que corre esa topología.
Después viene la frase que debería recolocar cómo lees cualquier aviso de incidente de un proveedor de IA (traducción nuestra):
Quien despliega no tiene forma fiable de saber [si la exposición ya ocurrió], porque la corrupción no deja error ni línea de log.
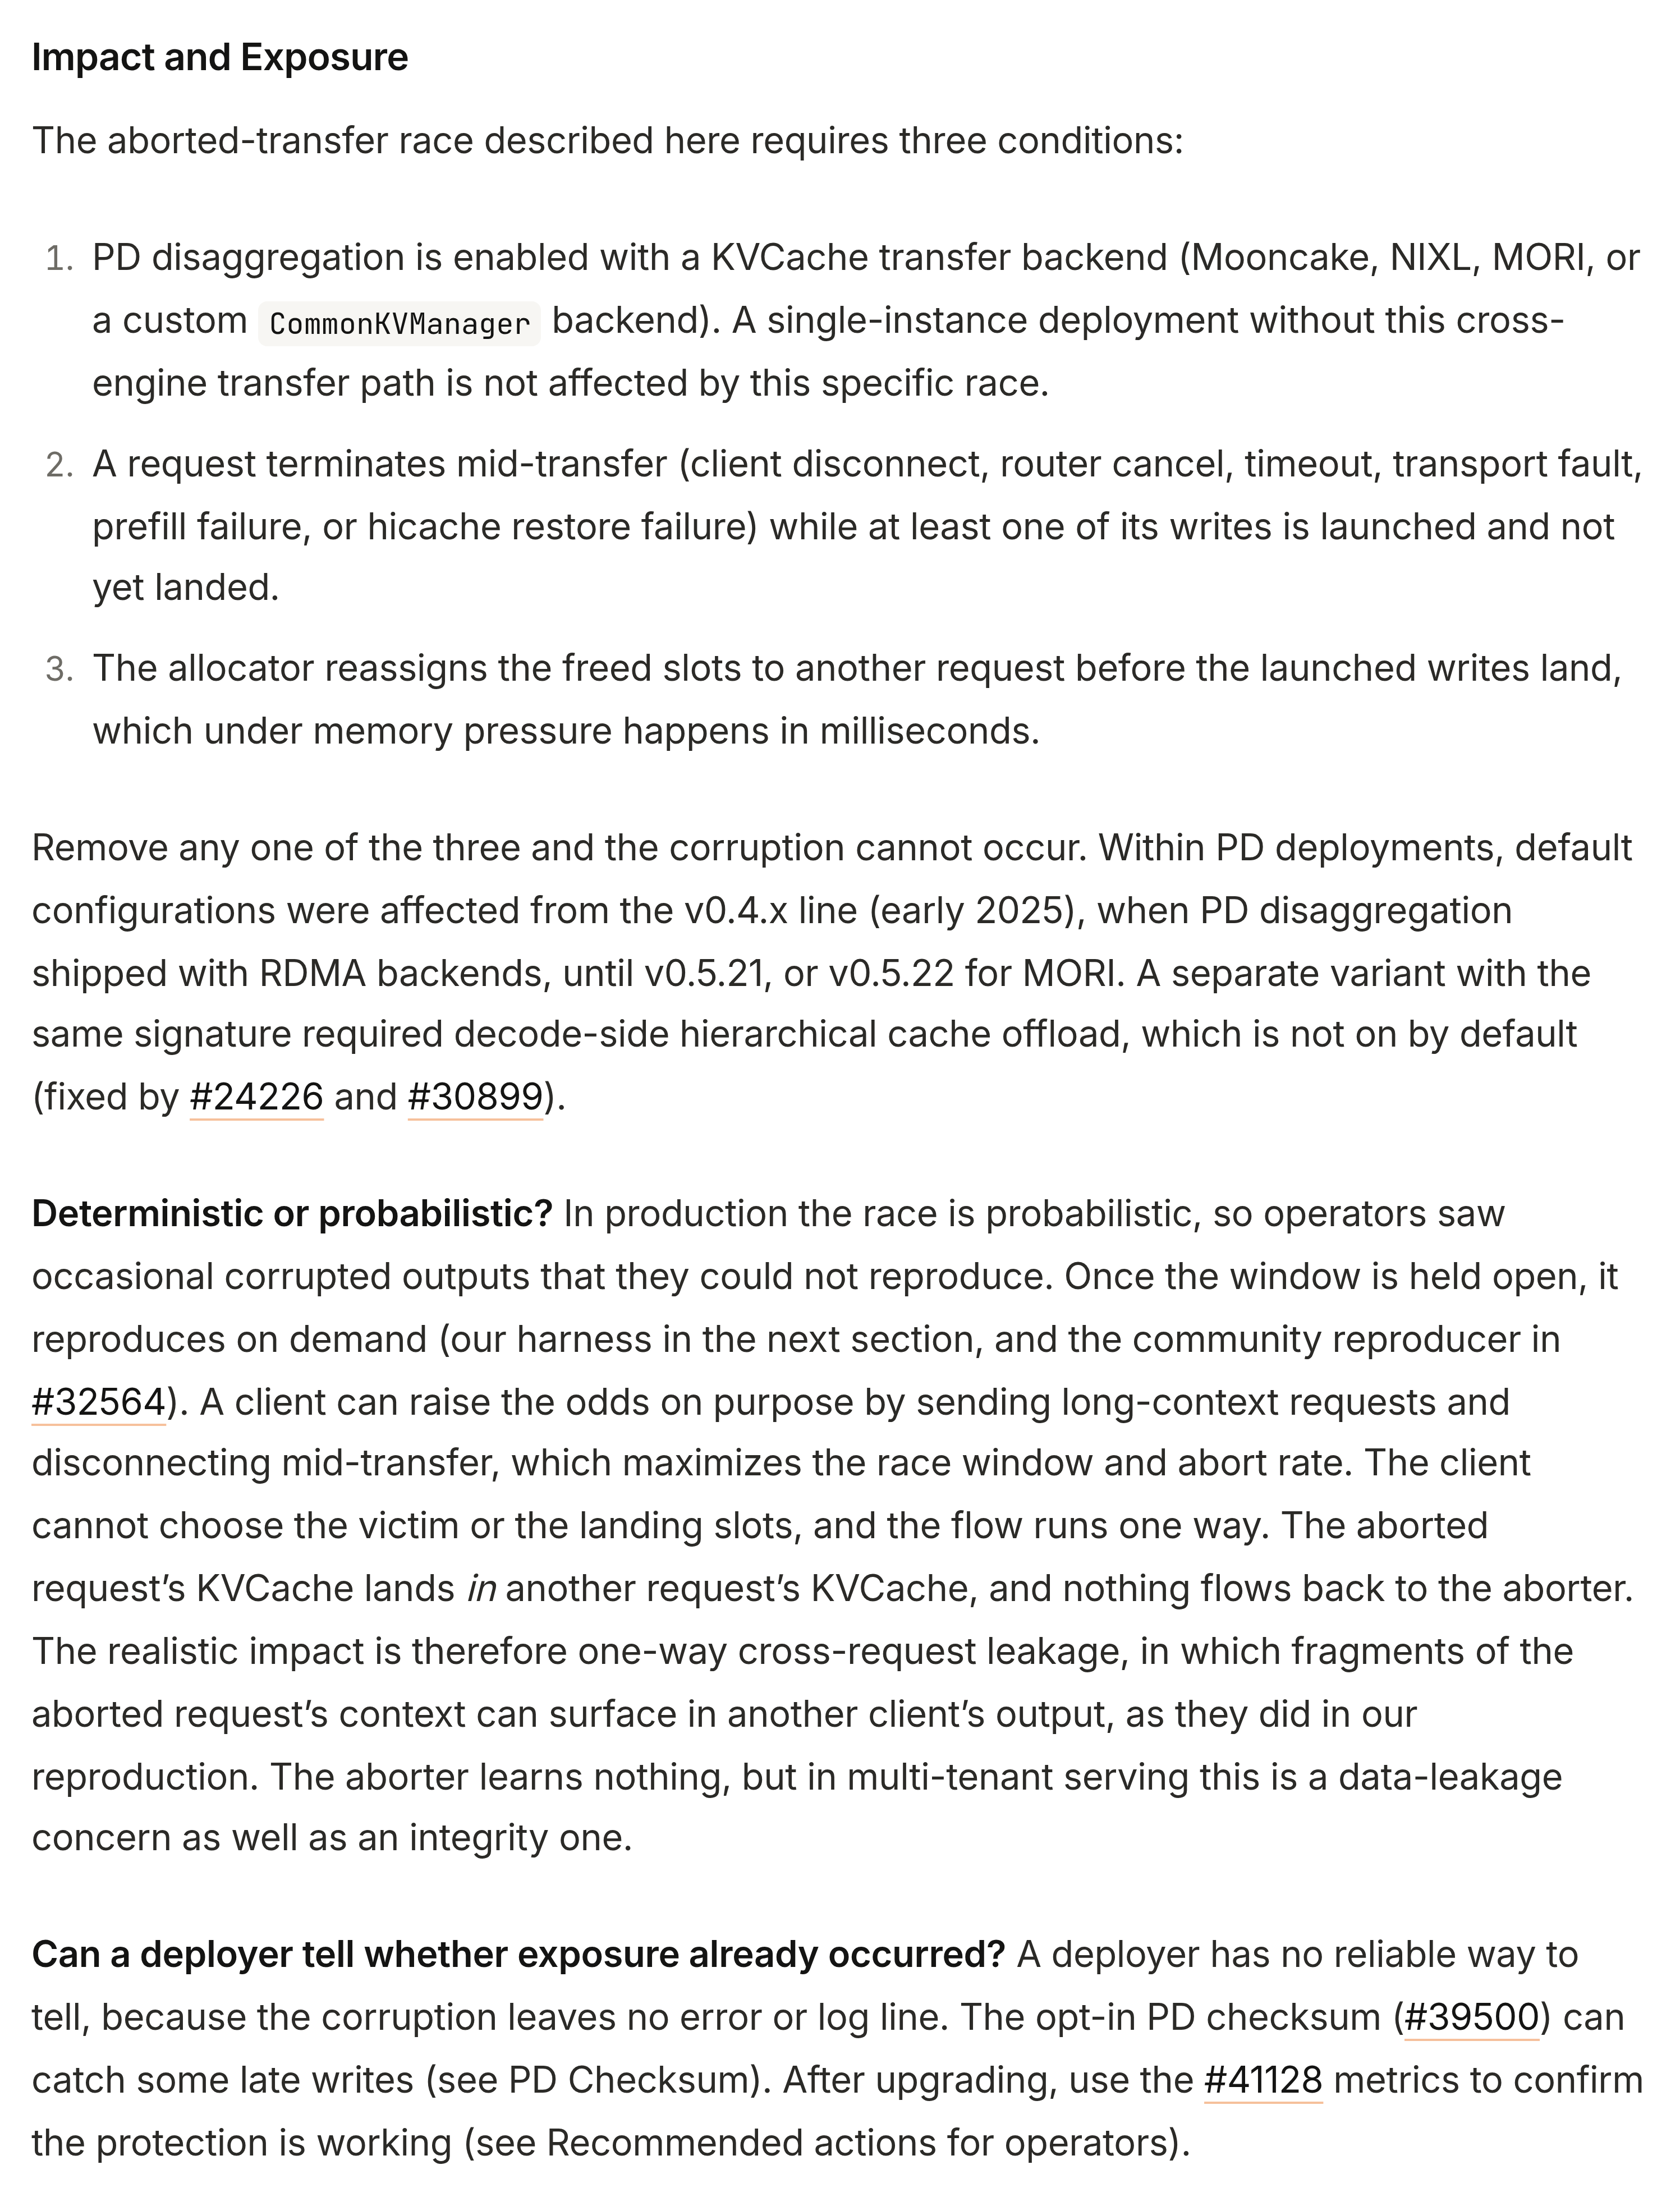
Las dos frases que pesan más que la cifra del titular: configuraciones por defecto afectadas desde principios de 2025, y ninguna forma fiable de que un operador determine después si hubo exposición. Fuente: SGLang / LMSYS.
La corrección que cierra la vía activa por defecto midió −0,38% de throughput, con un intervalo de confianza que cruza el cero. Es decir: la propiedad de aislamiento no se cambió por una velocidad que alguien pudiera medir. Simplemente estuvo desactivada por defecto durante año y medio, porque nadie la había planteado todavía como propiedad de seguridad.
Lo que significa que "no encontramos evidencia de exposición" es una afirmación sobre la ausencia de instrumentación, no sobre la ausencia de una brecha. Las dos cosas pueden ser ciertas a la vez. Solo una de ellas es lo que entiende el comprador.
Tres cosas que hacer el lunes
No son opiniones — son decisiones, en el orden en que cuestan dinero.
- Pregunta a tu proveedor de inferencia, por escrito, qué motor y qué versión ejecuta, si usa desagregación prefill/decode y si los checksums de transferencia están habilitados. Firmaste un contrato de tratamiento de datos que promete aislamiento a tu cliente. Si el proveedor no sabe decirte la versión, tampoco puede decirte si estuvo dentro de esa ventana — y la obligación sigue siendo tuya en cualquier caso.
- Haz que las pruebas de aceptación afirmen sobre el contenido de la salida, no sobre el código de respuesta, antes de que salga nada con forma de IA. Una comprobación de salida de referencia, una aserción de coherencia, un prompt canario cuya respuesta conoces — cualquier cosa que detecte una respuesta fluida y equivocada. Un 200 no es un aprobado.
- Presupuesta instrumentación en lugar de garantías. "Sin evidencia de exposición" debería sonarte a partida presupuestaria, no a certificado de buena salud. Si una fuga en tu stack no dejaría rastro, eso es lo primero que se arregla, antes que la fuga que todavía no has tenido.
La misma disciplina que aplicamos para contener código escrito por IA vale para la IA que lo sirve, y escribimos sobre un agente que silenció sus propias alertas de seguridad por el mismo motivo. En sistemas de IA, la forma por defecto de un fallo es una respuesta segura y bien escrita. La corrección hay que afirmarla sobre el contenido, o no se está afirmando. De eso se compone la mayor parte de nuestro trabajo de producción.
Puntos clave
- Las 155 respuestas afectadas son un suelo deducido de los logs de peticiones, no un total medido. Ninguna parte externa puede confirmarlo ni acotarlo.
- El bug produjo HTTP 200, recuento de tokens coincidente, latencia menor de la esperada y prosa coherente. Todas las señales sobre las que afirma una prueba competente estaban en verde.
- La misma clase de defecto estuvo en la configuración desagregada por defecto del motor de inferencia desde principios de 2025 hasta el 2 de octubre de 2026.
- La corrupción no deja error ni línea de log, así que ningún operador — Cloudflare incluida — puede probar retroactivamente que los prompts de un cliente no se filtraron.
- La corrección cuesta −0,38% de throughput, dentro del ruido de medición. Esto nunca fue un compromiso de rendimiento.
Preguntas frecuentes
¿Se filtraron mis datos? Si usaste GLM 5.3 en Workers AI entre el 27 de agosto y el 9 de septiembre de 2026 con prompts de más de unos 681.000 tokens, Cloudflare puede decirte si estabas en el conjunto que dedujo. Fuera de ahí, y para cualquier otro proveedor con serving desagregado, la respuesta honesta es que nadie puede establecerlo en ningún sentido — que es justamente el argumento de este post.
¿Es un problema de Cloudflare o de SGLang? De ninguno, en términos útiles. El bug de admisión está en el motor; la decisión de lanzar con un pool de caché menor que la ventana de contexto anunciada fue de Cloudflare; el patrón de pruebas que no lo detectó es de todo el sector. Cloudflare es uno de los pocos proveedores que publicó detalle suficiente como para poder ser criticado siquiera.
¿Afecta a la inferencia en un solo nodo? La condición de carrera concreta de transferencia abortada requiere desagregación prefill/decode con un backend de transferencia de caché. Un despliegue de instancia única no tiene esa vía. La lección general — una lectura corrupta en un LLM aflora como texto fluido, no como error — no depende de la arquitectura.
¿Qué debería entrar ahora en mi cuestionario de proveedores? Motor y versión, si hay serving desagregado en uso, si las comprobaciones de integridad en la transferencia están activas, y qué instrumentación detectaría una contaminación entre peticiones si ocurriera. La última es la pregunta que casi nadie hace y la única que produce evidencia.