Costos de IA · LLM · Ingeniería
Precio de LLM bajó, tu factura no: el recorte fue al caché
La inferencia bajó hasta 80% en 2026 y tu factura de IA no se movió. El recorte aterrizó en las lecturas de caché, la columna que nadie compara.
Si tu equipo elige modelo mirando la tabla de precios, lo está eligiendo con el número equivocado. El precio de la inferencia cayó hasta 80% este año y la mayoría de las facturas de IA no se movió, porque el recorte aterrizó casi por completo en una columna que casi nadie lee: las lecturas de caché. En un producto agéntico — cualquier cosa que corra en bucle, cargue una base de código en contexto o sostenga una conversación durante varios turnos — es el precio de la lectura de caché, y no el precio de entrada y salida de portada, el que gobierna la mayor parte de la cuenta.
De ahí salen dos consecuencias duras: el ranking público de modelos no sirve para la carga que realmente ejecutas, y si capturaste o no el descuento de este año lo decidió la arquitectura de prompts que desplegaste hace meses, no el anuncio que leíste la semana pasada.
Dos clases de número en este artículo
Cada precio citado proviene de la tabla publicada por el propio proveedor, capturada el 26 de octubre de 2026, y cada proporción la calculamos nosotros a partir de esas tablas. Las capturas están en el texto para que verifiques la cuenta.
Los porcentajes de ahorro son otra clase de afirmación. "Cuesta 40% menos en cargas típicas", "las facturas típicas bajan cerca de 25%", "el costo de la inteligencia de Fable cayó 54%" — cada uno es una empresa reportando un número sobre su propio producto, a partir de sus propias cargas, sin reproducción independiente. Los citamos y los marcamos, y no apoyamos el argumento en ellos. Donde el argumento necesita un número medido, usa un precio publicado o un evaluador independiente.
Cambió exactamente un número
Claude Fable 5 y Claude Fable 5.1 tienen precio idéntico en cada línea que un comprador suele comparar: US$ 10 por millón de tokens de entrada, US$ 50 de salida, US$ 12,50 por escritura de caché de cinco minutos, US$ 20 por la de una hora. La única celda distinta en la lista de Anthropic es "Hits and refreshes": US$ 1 por millón en Fable 5, US$ 0,25 en Fable 5.1. Un recorte de 75% con el precio de portada intacto hasta el centavo.
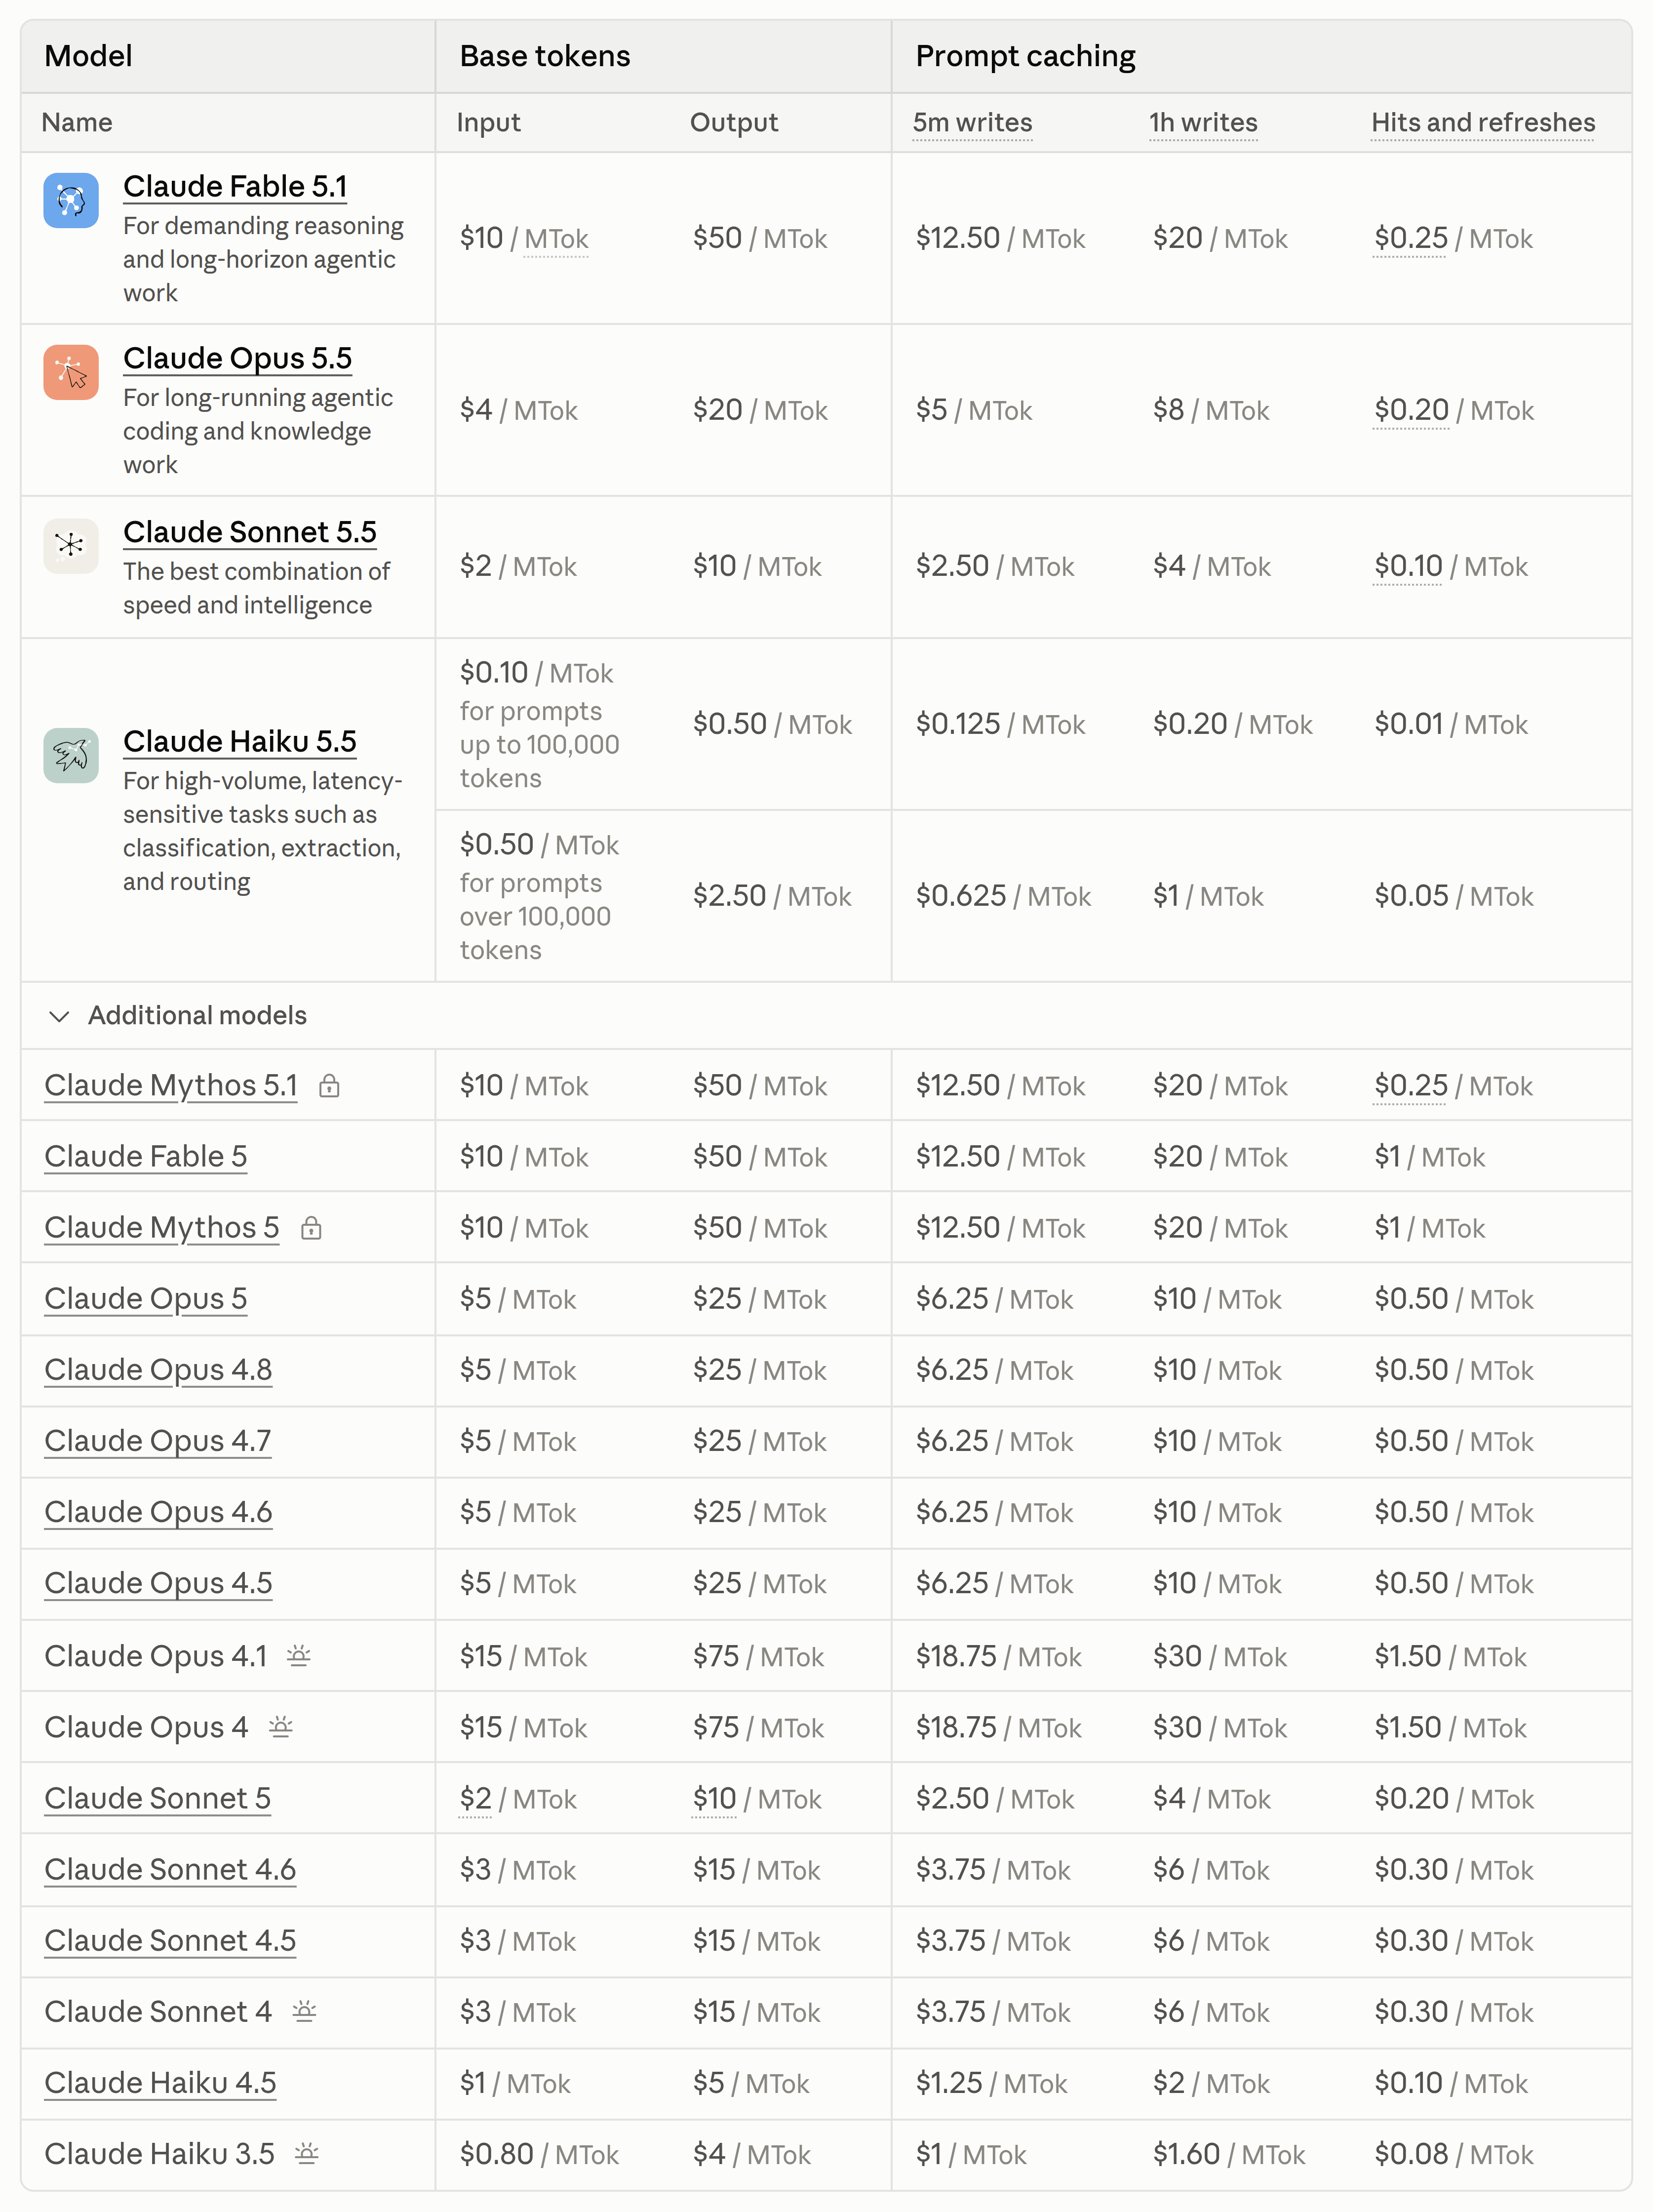
Sube una fila y el ranking empieza a tambalear. Fable 5.1 cuesta 2,5x Opus 5.5 en entrada (US$ 10 frente a US$ 4) pero solo 1,25x en lecturas de caché (US$ 0,25 frente a US$ 0,20). La prima que el comprador lee en la página es aproximadamente el doble de la prima que el agente realmente paga. Una tabla, dos rankings defendibles, según la columna en la que viva tu carga.
Y la proporción no es una constante memorizable. El precio del hit de caché como fracción del precio de entrada da 2,5% en Fable 5.1, 5% en Opus 5.5 y Sonnet 5.5, 10% en Haiku 5.5 — y 10% en el ya sustituido Fable 5. La profundidad del descuento de caché es una decisión por modelo, rehecha en cada lanzamiento.
El propio proveedor describe el mecanismo
No hay que leer entre líneas. El anuncio de Opus 5.5 de la propia Anthropic dice que las lecturas de caché "constituyen la mayor parte del costo del trabajo agéntico y de programación", las cobra a US$ 0,20 por millón y llama a eso 60% menos que Opus 5. Entrada y salida, en el mismo párrafo, bajaron 20%.
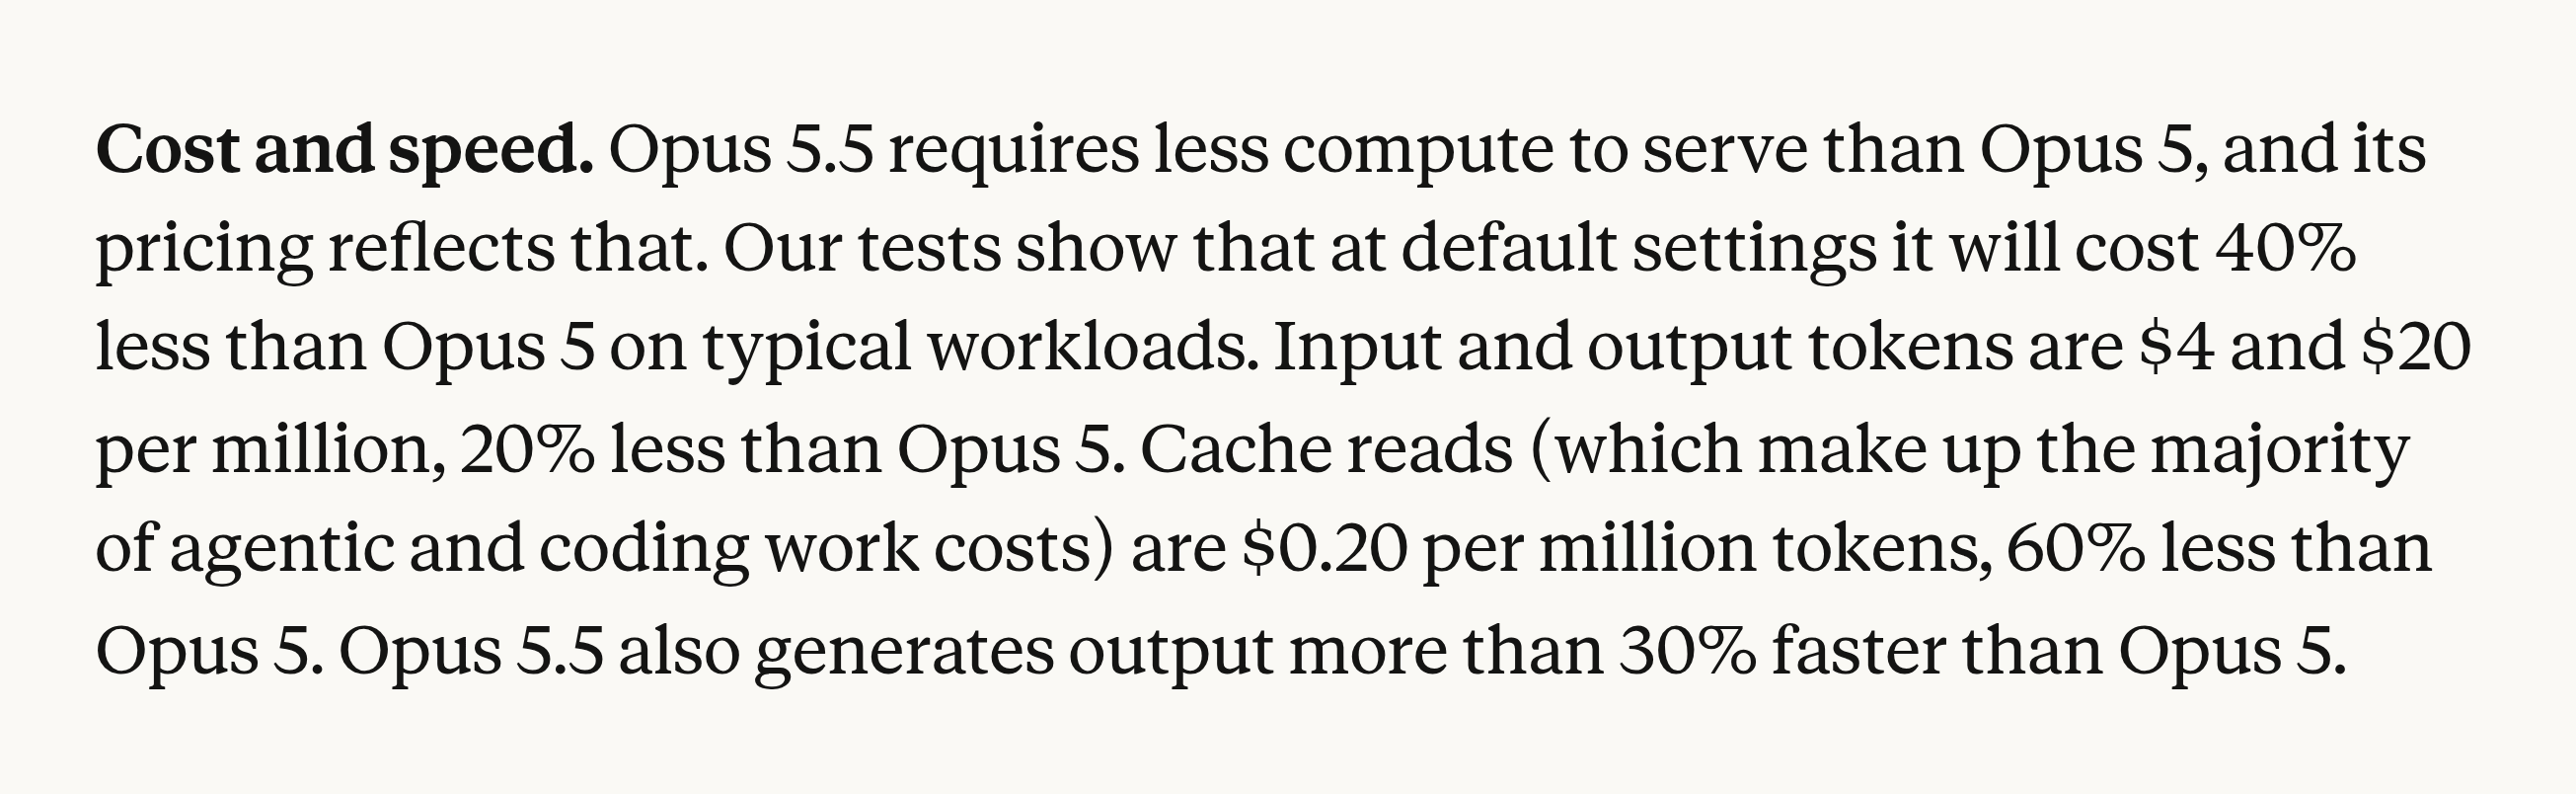
El recorte es tres veces más profundo en la columna que nadie cita que en la que ocupó los titulares.
Adónde va el dinero de un agente
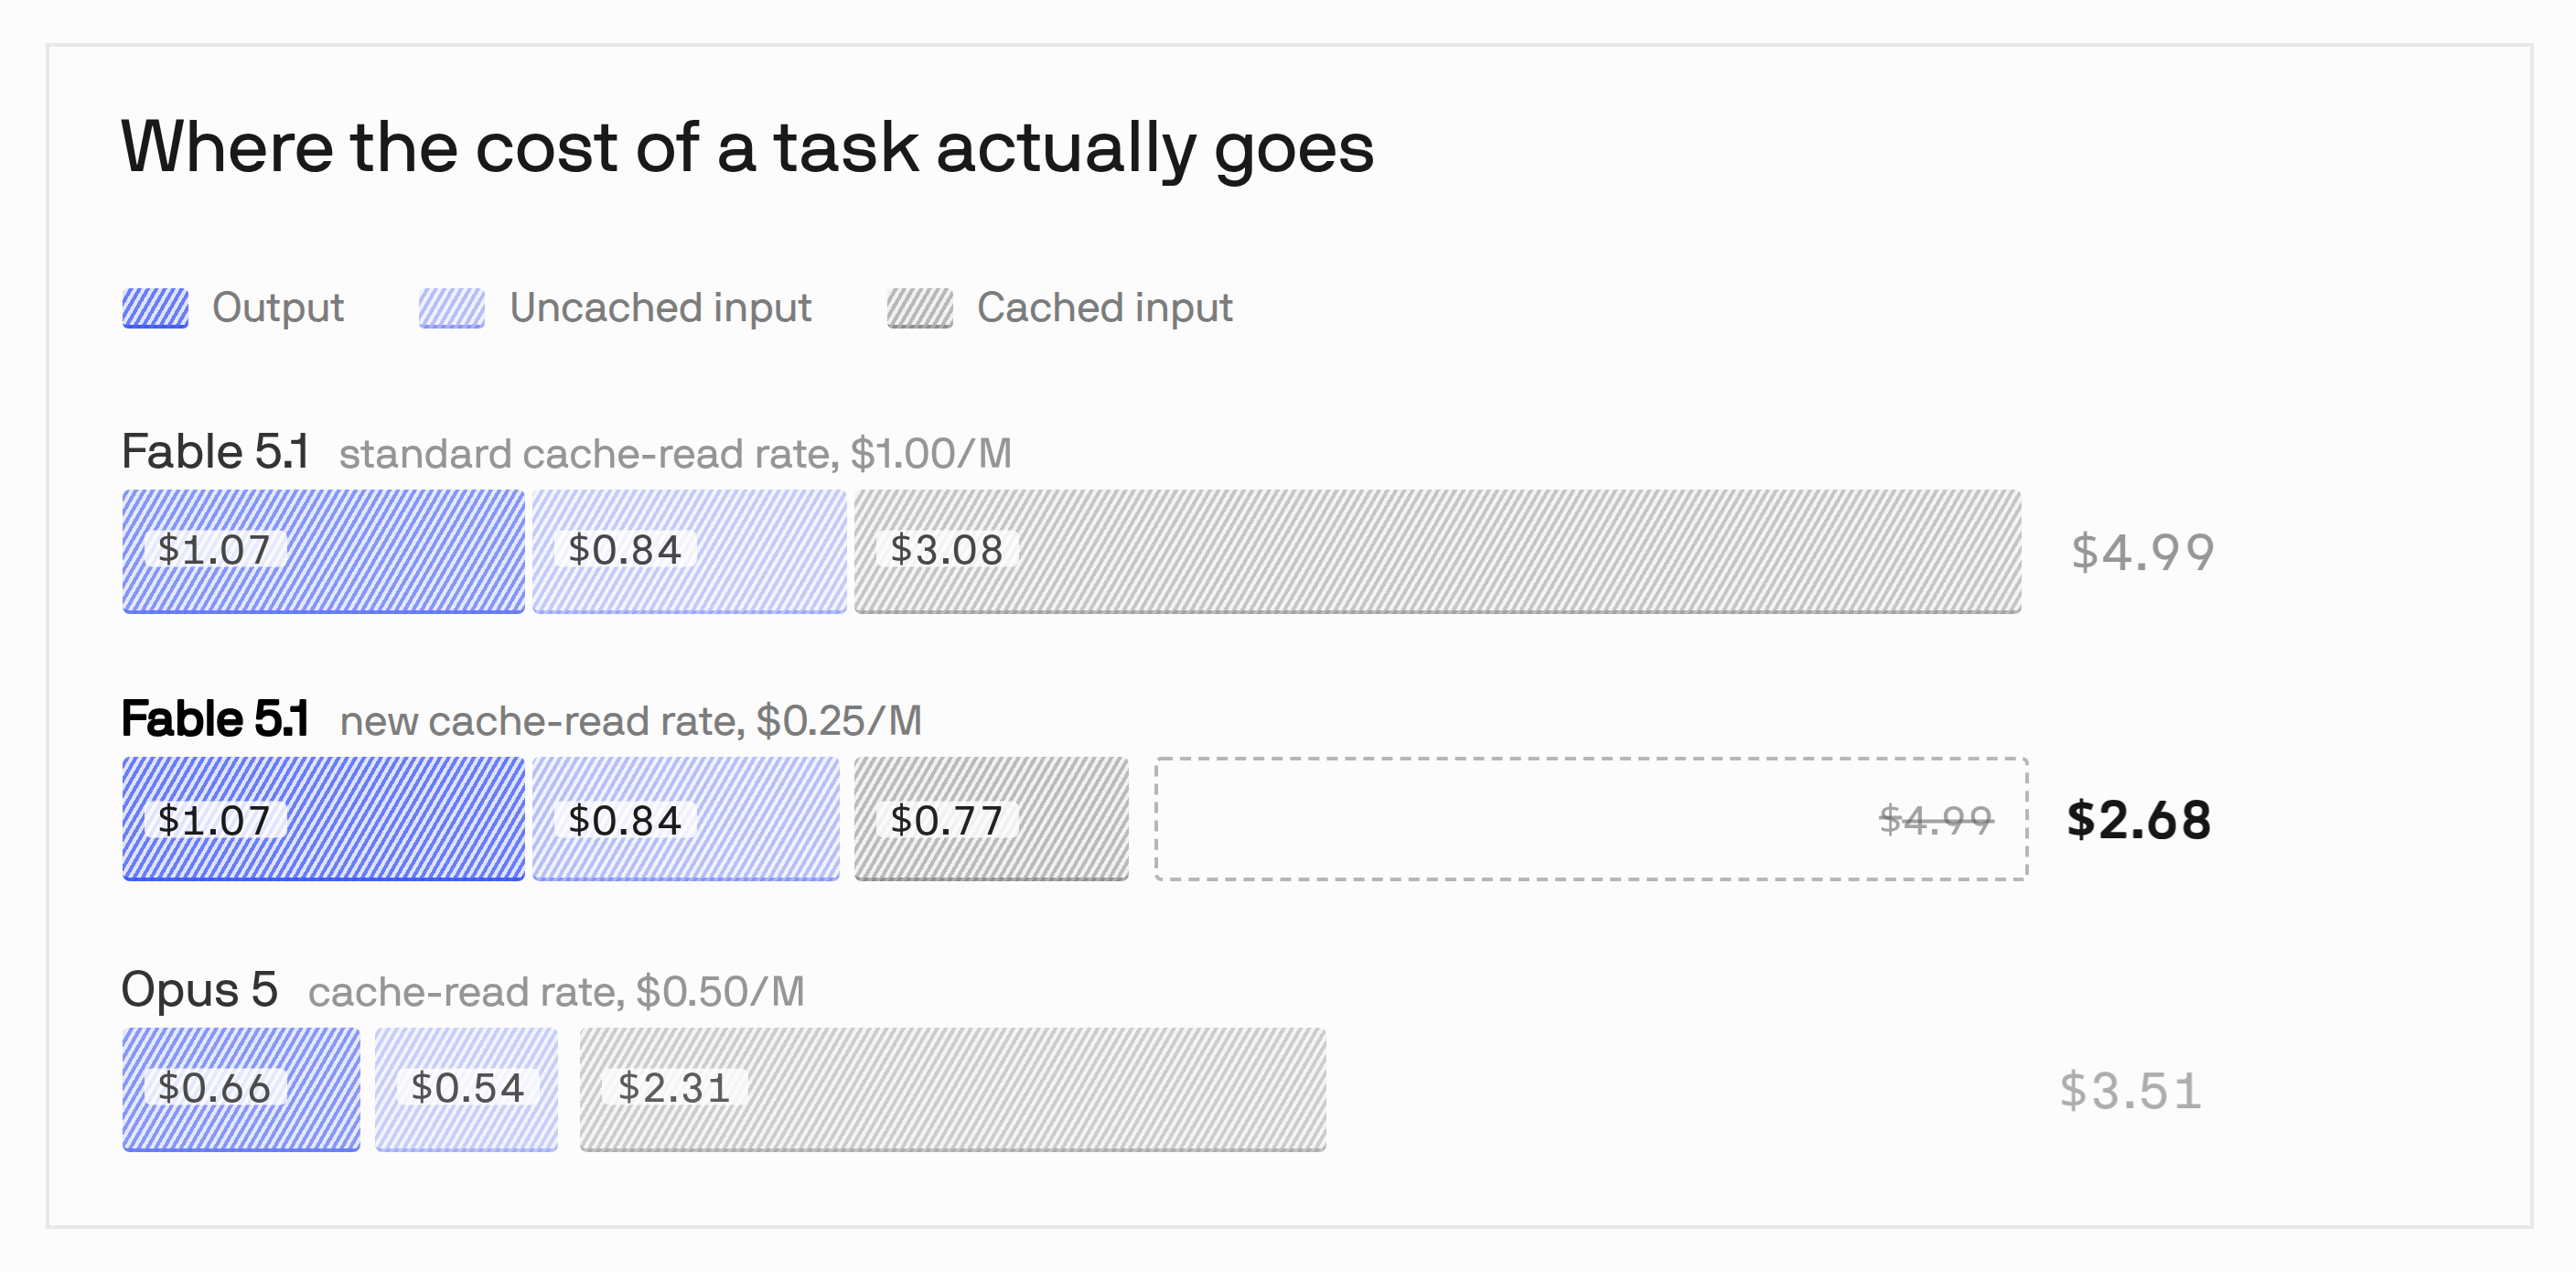
Cognition publicó el desglose de una sola tarea de código en su propio benchmark: salida US$ 1,07, entrada no cacheada US$ 0,84, entrada cacheada US$ 3,08 — US$ 4,99 en total a la tarifa anterior de US$ 1,00 por millón de lectura de caché. La entrada cacheada es el 62% de esa cuenta. Las dos columnas que anuncia la página de precios explican el 38%. La mezcla de tokens detrás es de ~3 millones de tokens cacheados frente a unos 21 mil de salida y 70 mil de entrada no cacheada, que ellos resumen como "más del 95% de los tokens en ambos modelos son lecturas de caché".
Cognition vende un agente construido sobre estos modelos, así que lee sus cifras de ahorro como lo que son: la afirmación de un proveedor sobre sí mismo. Lo que sí se sostiene es la estructura de costo, porque Anthropic la afirma de forma independiente y la proporción se reproduce desde los precios publicados.
Ahora la multa por equivocarse. En Opus 5.5 una escritura de caché de cinco minutos cuesta US$ 5 por millón frente a US$ 0,20 del hit: 25x por reenviar contexto que el modelo ya tiene. Incluso la entrada no cacheada corriente cuesta 20x el precio del hit. Un prompt que rompe la caché en cada turno — un timestamp arriba del system prompt, una lista de herramientas que cambia de orden, un historial reconstruido en vez de ampliado — paga ese múltiplo en todos los turnos, en silencio, y ningún log tuyo lo llama error.
Invalidar la caché no es un problema de rendimiento. Es un evento de facturación.
La misma aritmética, la respuesta contraria
Aplica el razonamiento en OpenAI y apunta al lado opuesto. Su tabla publicada lista gpt-6-astra a US$ 10,00 de entrada / US$ 50,00 de salida / US$ 1,00 de entrada cacheada, y gpt-6.1-sol a US$ 2,00 / US$ 10,00 / US$ 0,10. Astra cuesta 5x Sol en el número que lees y 10x en el número que paga de verdad una carga dominada por caché.
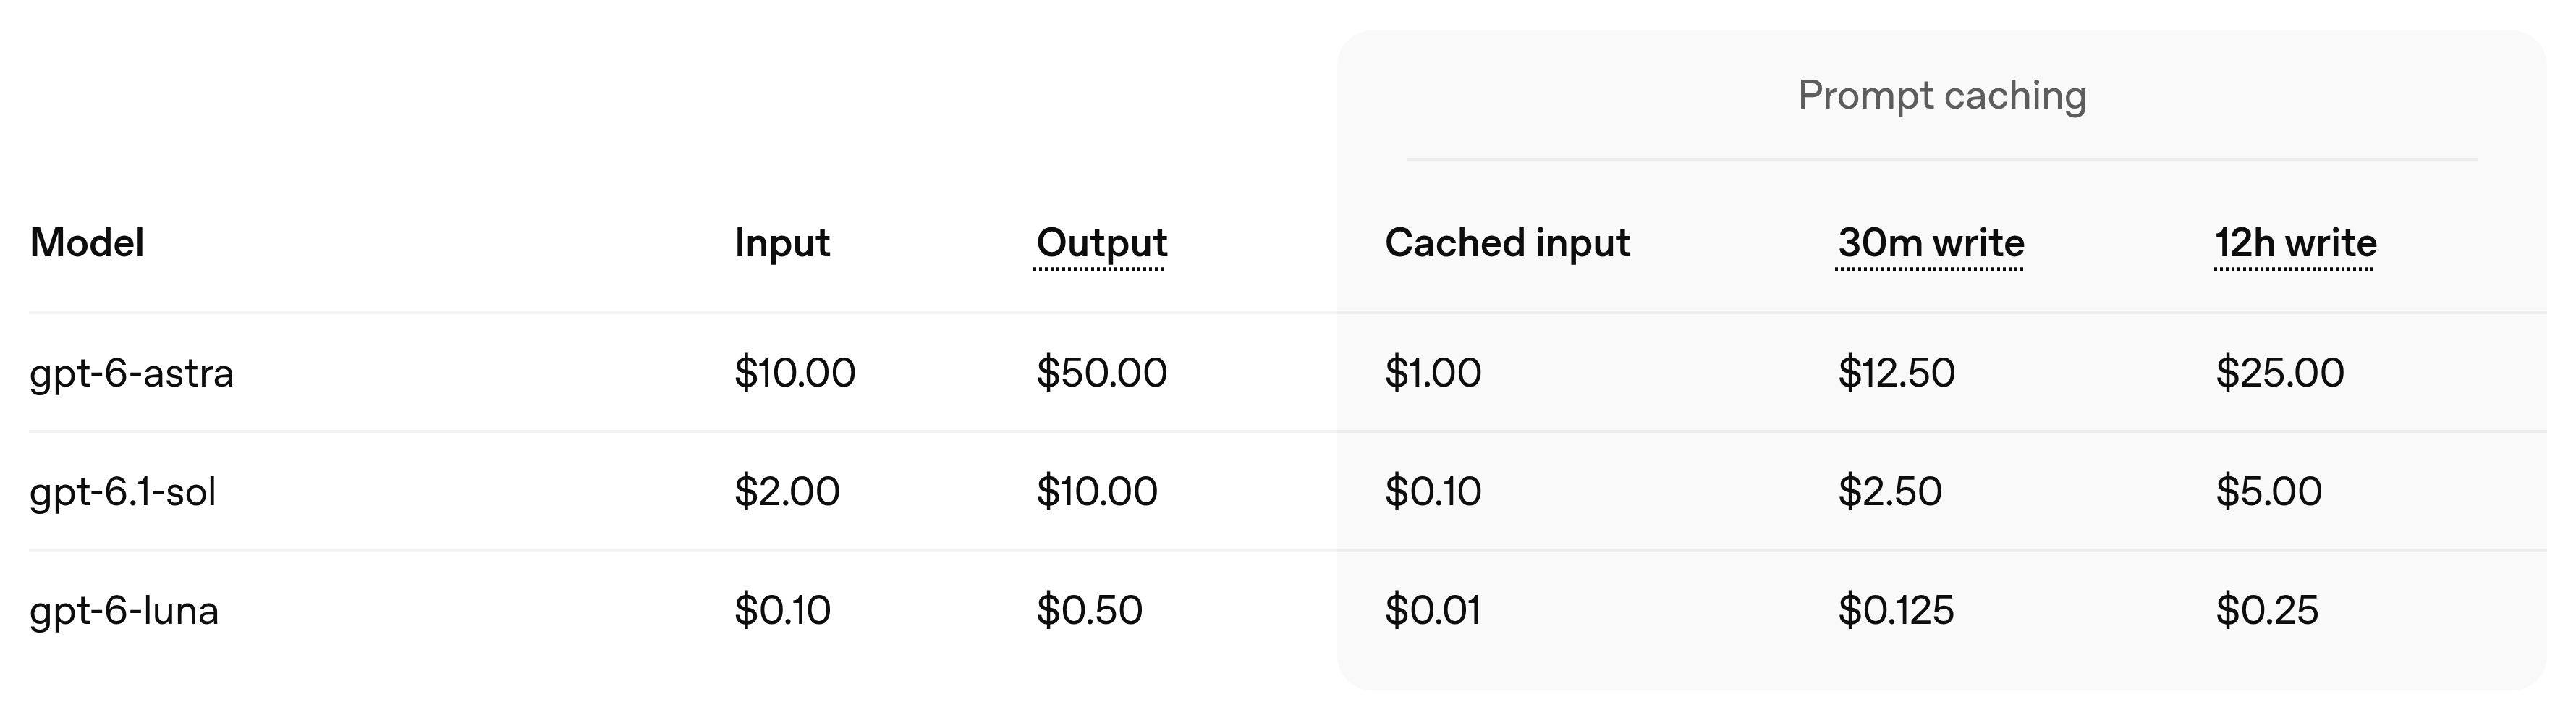
La corrección se invierte. El mismo razonamiento que vuelve al modelo más caro de Anthropic más barato de lo que parece para trabajo agéntico vuelve al modelo más caro de OpenAI más caro de lo que parece. Dos proveedores, la misma estructura de precios, correcciones opuestas: no hay regla general que puedas llevar de uno al otro. Solo está la aritmética, modelo por modelo, contra tu propia mezcla de tokens.
Un recorte de precio no es un recorte de factura
Artificial Analysis midió Fable 5.1 en US$ 3,76 por tarea del Intelligence Index a esfuerzo máximo, frente a US$ 3,14 de Fable 5. Es 20% más por tarea, en el mismo lanzamiento que trajo el recorte de 75% en lectura de caché, porque el modelo nuevo emite alrededor de 1,7x más tokens de salida.
Artificial Analysis declara en esa misma página que hizo evaluación previa al lanzamiento para Anthropic, algo que conviene saber y que vuelve el hallazgo más interesante, no menos, porque contradice el marketing del proveedor.
Precio por token y costo por tarea son magnitudes distintas, y un mismo lanzamiento puede moverlas en direcciones opuestas. Solo una de las dos aparece en tu factura.
Qué hacer antes del próximo anuncio
- Instrumenta la tasa de aciertos de caché. Ambos proveedores devuelven el conteo de tokens cacheados en el payload de uso de cada respuesta. Si hoy no puedes decir qué fracción de tu entrada son lecturas de caché, no puedes proyectar tu gasto en IA, y ninguna página de precios te lo va a decir.
- Proyecta desde tu mezcla de tokens, no desde la lista de precios. Multiplica la mezcla medida por cada columna, modelo por modelo. Ese número, y no el de portada, es lo que cuesta un cambio de modelo.
- Trata la estructura del prompt como control de costos. Prefijo estable, historial solo aditivo, nada volátil por encima del punto de caché. Es una decisión de arquitectura con un multiplicador de 25x adjunto, lo que la saca del cajón de "detalle de prompt engineering" donde suele vivir.
- Rehaz el ranking por carga cuando cambien los precios. Un recorte que cae en la columna de caché vale muchísimo para quien tiene contexto reutilizable largo y no vale nada para quien hace clasificación de un solo disparo.
Es el trabajo que hacemos al llevar software construido con IA a producción en SV Dev: la revisión de costos ocurre antes de elegir el modelo, no después de la primera factura sorpresa. Es la misma clase de problema que fijar versiones de modelo y contener el código escrito por IA: una decisión que parece un detalle de implementación al hacer commit y se convierte en una línea del estado de resultados dos trimestres después.
Puntos clave
- Los recortes de precio de LLM en 2026 cayeron sobre todo en las lecturas de caché, una columna que el precio de portada nunca cita.
- Fable 5 y Fable 5.1 tienen precio de portada idéntico; solo cambió el precio de lectura de caché, un 75%.
- El ranking por portada y el ranking por caché no coinciden, y discrepan en direcciones opuestas en Anthropic y en OpenAI.
- Un fallo de caché en Opus 5.5 cuesta hasta 25x un acierto, cobrado en cada turno.
- Un recorte del 75% puede producir igualmente una factura mayor si el modelo emite más tokens de salida.
Preguntas frecuentes
¿Qué es una lectura de caché y por qué domina el costo agéntico?
Cuando un modelo relee contexto que ya procesó — system prompt, esquema de herramientas, base de código, turnos previos de la conversación — ese contexto puede servirse desde una caché de prompts con un descuento fuerte, en lugar de reingerirse al precio completo de entrada. Los agentes releen cantidades enormes de contexto estable en cada turno, así que las lecturas de caché pasan a ser la mayoría de sus tokens y, con ellos, la mayoría de la factura.
¿Por qué no bajó mi factura de IA si bajaron los precios?
Probablemente por una de tres razones: tu carga tiene poco contexto reutilizable, así que el descuento de caché no te aplica; tus prompts invalidan la caché en cada turno y pagas escritura o entrada completa de forma repetida; o migraste a un modelo nuevo que produce más tokens de salida por tarea, lo que puede anular el recorte en lectura de caché.
¿El modelo más caro es siempre la elección equivocada para agentes?
No, y ese es justamente el punto. En la tabla de Anthropic la prima del modelo tope se reduce a la mitad al tasarla por lecturas de caché; en la de OpenAI prácticamente se duplica. El ranking depende del proveedor y de tu mezcla de tokens, así que hay que calcularlo, no suponerlo.
¿Cómo mido esto sin herramientas nuevas?
Lee el objeto de uso que ya recibes en cada respuesta de la API. Suma tokens de entrada cacheados, no cacheados y de salida por tarea durante una semana, y multiplica esos tres totales por los tres precios de cada modelo candidato. Ese es todo el método.