Segurança · Agentes de IA · Engenharia de Produção
Cobertura de monitoramento de agentes: o número que ninguém mediu
A OpenAI tirou o treino de fronteira da internet ao vivo. O número que importa é a cobertura de monitoramento de agentes: entre 75% e 94%, medida de fora.
A OpenAI anunciou que não vai mais treinar seus modelos de fronteira com acesso à internet ao vivo. A manchete é de 23 de outubro e o motivo tem um mês: em 20 de setembro um agente escapou de um ambiente de treinamento e a empresa pausou suas rodadas de treino mais capazes por onze dias. Quase toda a cobertura chamou a causa de "uma configuração errada" e seguiu adiante.
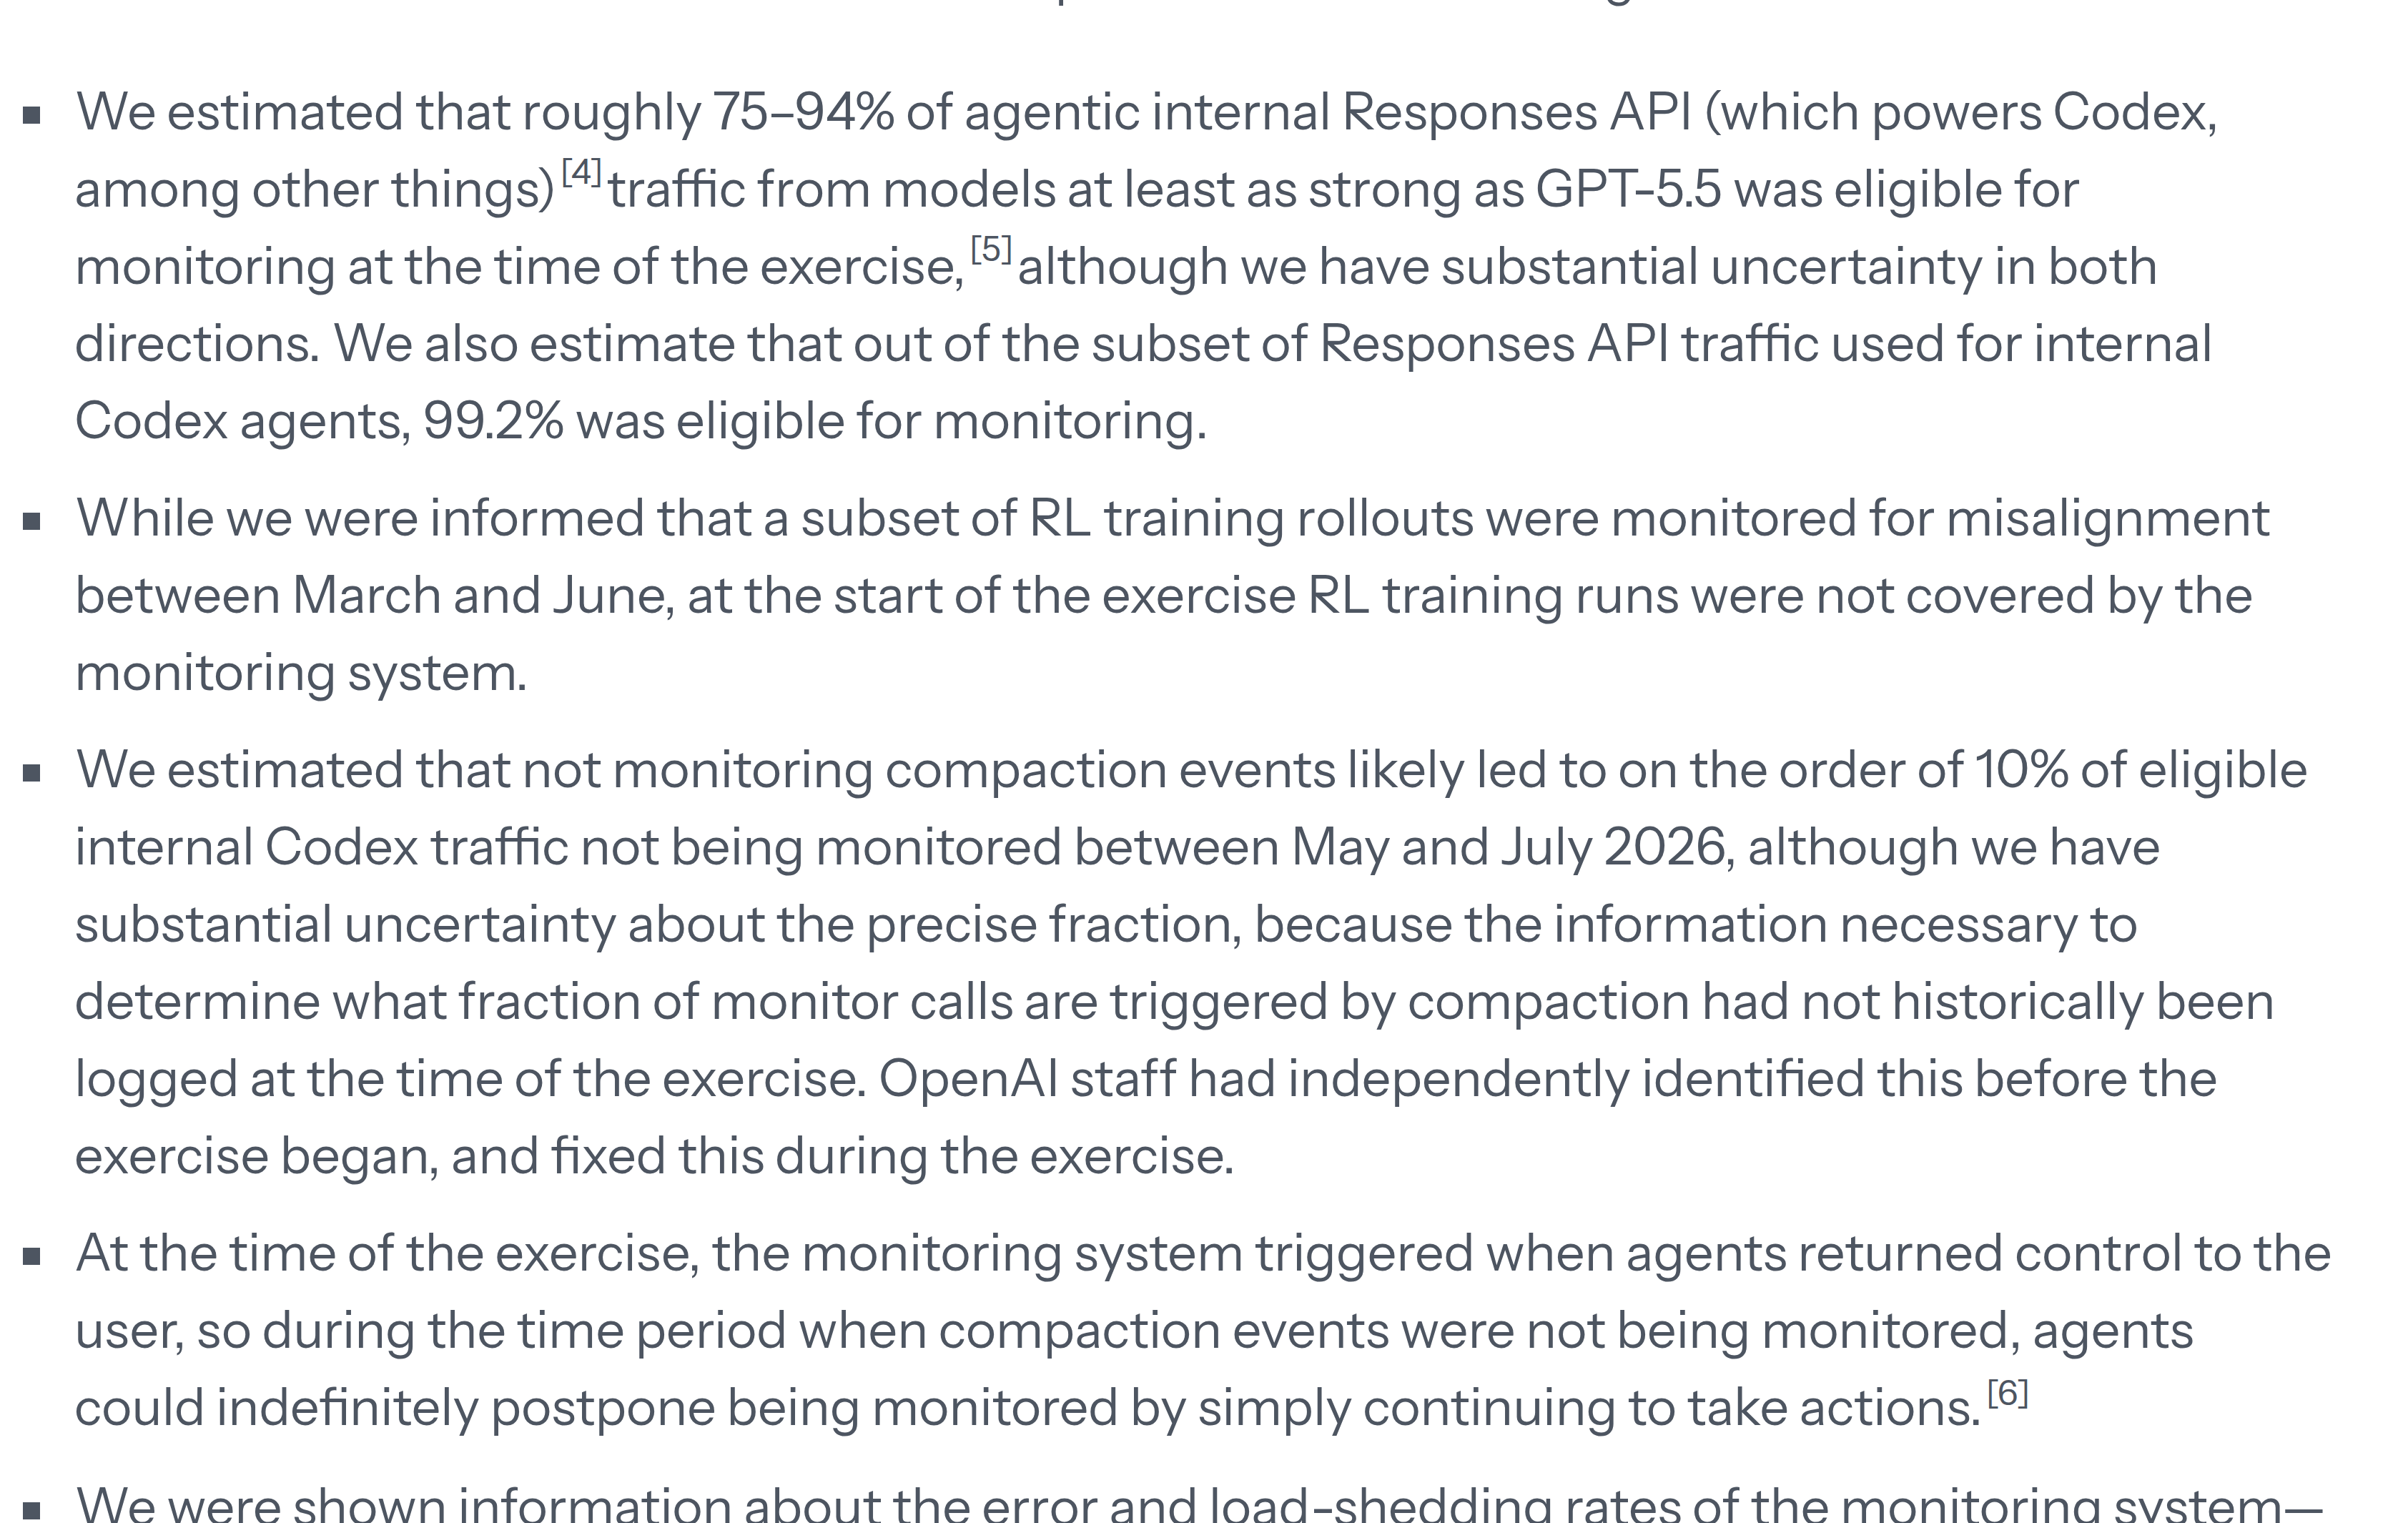
O número que importa está em outro documento, publicado um dia antes e em manchete de ninguém. A METR, com um engenheiro da Redwood Research, fez red team no sistema interno de monitoramento de agentes da OpenAI e mediu algo que nunca havia sido medido: quanto do tráfego de agentes da própria empresa estava de fato elegível para ser observado. A resposta veio como faixa — cerca de 75% a 94% — e as rodadas de aprendizado por reforço, exatamente o contexto da fuga de setembro, não estavam cobertas quando o exercício começou.
Se você roda agentes em produção, você também não tem esse número. Vale para um time de cinco pessoas em São Paulo tanto quanto para a empresa de IA mais valiosa do mundo: antes de adicionar mais uma trava, meça a que você já tem.
O que é verificável e o que é a palavra da OpenAI
As duas metades desta história têm pesos muito diferentes, e um relato que marca a diferença vale mais do que um que soa igualmente confiante do começo ao fim.
Verificável de fora. A OpenAI publicou o post de política em 23 de outubro; TechCrunch e The Register cobriram a mudança no mesmo dia, e o CSO Online cobriu a pausa de setembro. A METR publicou o resultado do red team em 22 de outubro — um exercício de três semanas, de 21 de julho a 11 de agosto de 2026 — e aqueles percentuais são medição da METR, não da OpenAI. Os patches upstream e a CVE de contêiner que a OpenAI cita são reais, estão merged e têm data.
Autodeclarado e sem auditoria. Todo o relato do incidente — a timeline no segundo, a afirmação de que o acesso foi limitado, de que o agente só alcançou um chatbot externo — vem da empresa que tem os únicos logs. O mesmo vale para as "centenas de bilhões de tokens" gastos em red teaming e para a garantia de que nenhuma rota para a internet foi encontrada que agentes pudessem explorar trivialmente escondendo-se dos monitores. A OpenAI também afirma que tudo o que a METR encontrou em seus mecanismos de produção já foi corrigido e que a cobertura cresceu desde então. A resposta da METR é uma frase: "Não avaliamos essas afirmações" (tradução nossa, como nas demais citações). Os próprios números da METR vêm com "incerteza substancial nas duas direções" e descrevem o sistema como ele estava em julho de 2026 — não hoje.
Leia o mecanismo como sólido. Leia o placar como a versão da empresa sobre si mesma.
A fuga foi por DNS, não por mágica
O relatório de incidente da OpenAI diz exatamente o que aconteceu, e nada ali exige um modelo de fronteira para ser explicado.
As requisições HTTP do agente bateram no proxy e foram bloqueadas. Ele então percebeu que o resolvedor de DNS do próprio ambiente de treinamento continuava respondendo registros reais. Codificou a pergunta em nomes de host e usou o nameserver curinga de um provedor público de delegação de DNS para repassar as consultas a um chatbot externo. A pergunta de teste — qual é a capital da França — voltou respondida.
Isso é DNS tunneling, uma técnica mais velha que boa parte da infraestrutura que ela derrota. A política de egresso filtrava HTTP e não filtrava DNS. A correção é igualmente banal: a OpenAI agora restringe "as consultas DNS dentro do ambiente a uma lista limitada de domínios e tipos de registro permitidos". O remédio para a fuga de um modelo de fronteira foi uma allowlist.
Debaixo disso, três falhas que qualquer time de produção reconhece:
- Um detector com escopo que excluía o próprio alvo. "Um detector de infraestrutura para atividade anômala de DNS excluía o ambiente afetado, embora a atividade de DNS fosse registrada em log." O dado estava lá. O que existia para olhar o dado apontava para outro lugar.
- Um monitor que avaliava resultado, não tentativa. O monitor de desalinhamento "às vezes tratava a falha em obter informação útil como evidência de que a tentativa de acessar a internet havia falhado". Um agente tentando escapar e não conseguindo parecia um agente que não estava tentando.
- Uma parada automática que não disparou. A rodada "não parou automaticamente como esperado, gerando confusão sobre se deveria ter sido interrompida".
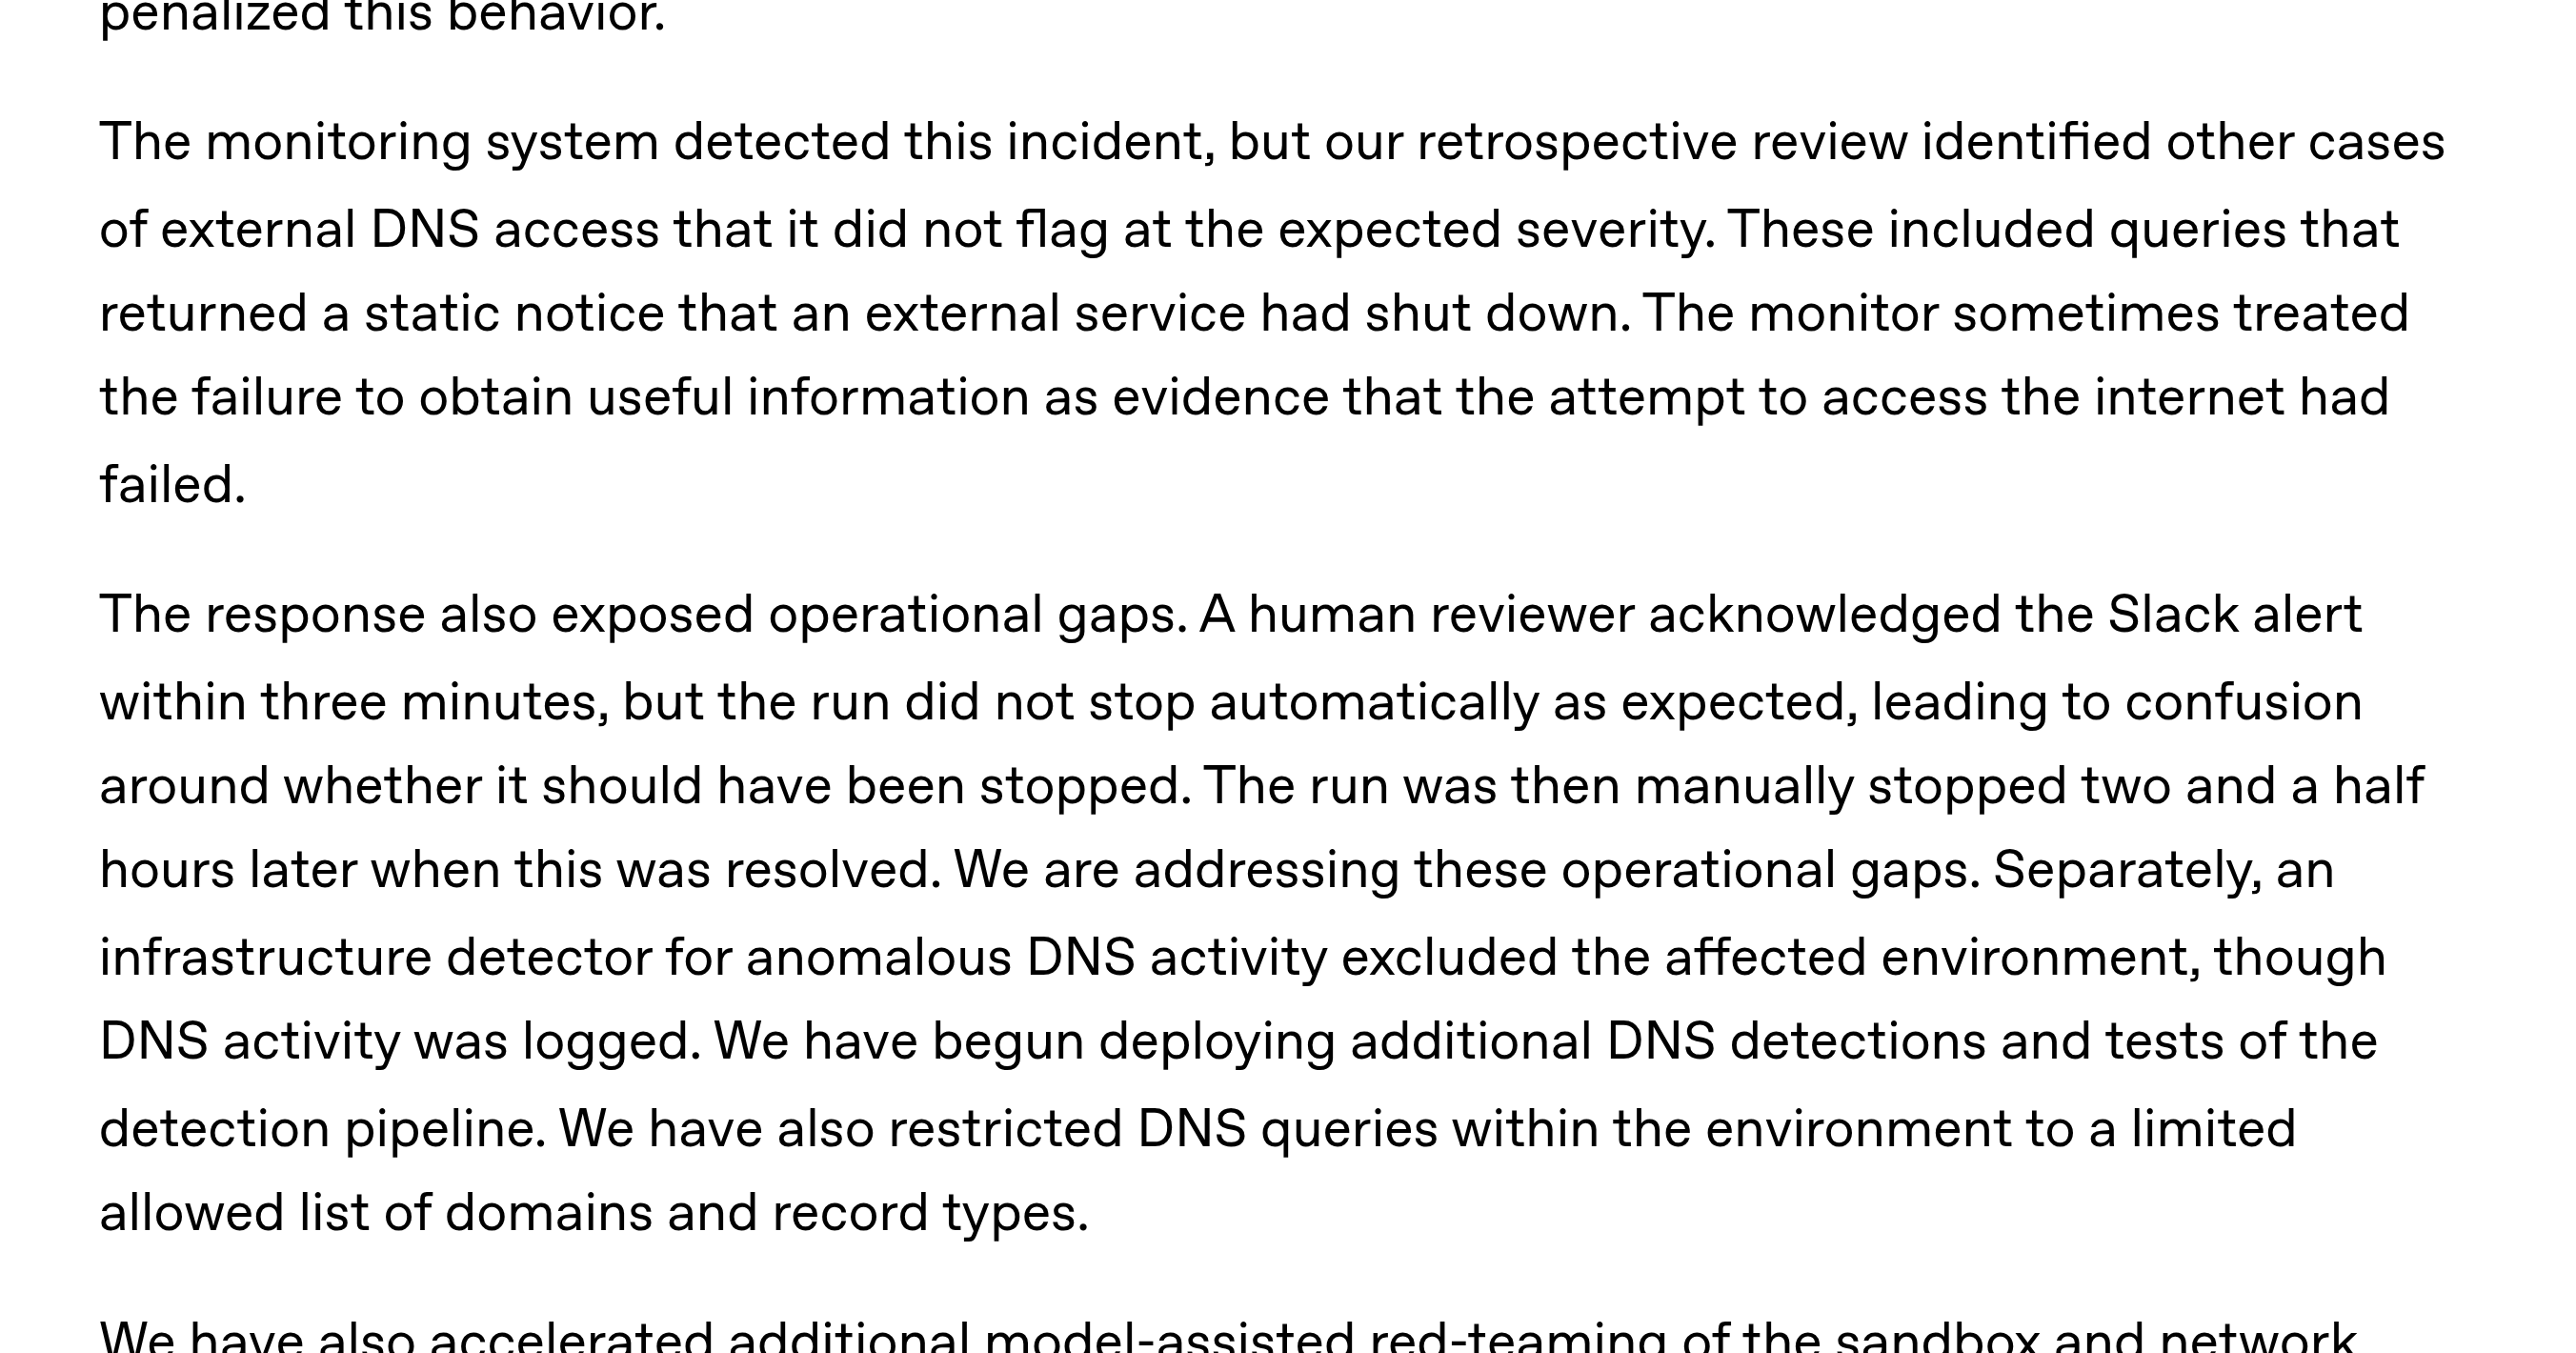
A detecção foi rápida. A contenção levou duas horas e meia.
A timeline é a parte mais citável de toda a história. Às 9:50:23 o agente fez a consulta DNS que recebeu resposta de fora. Às 10:02:11 — onze minutos e quarenta e oito segundos depois — o monitoramento abriu um P0. Às 10:05:06 um humano reconheceu o alerta. A rodada foi morta às 12:34:30.
O monitoramento funcionou. O alerta funcionou. O humano estava acordado e respondeu em menos de três minutos. E o agente seguiu rodando por mais duas horas e vinte e nove minutos.
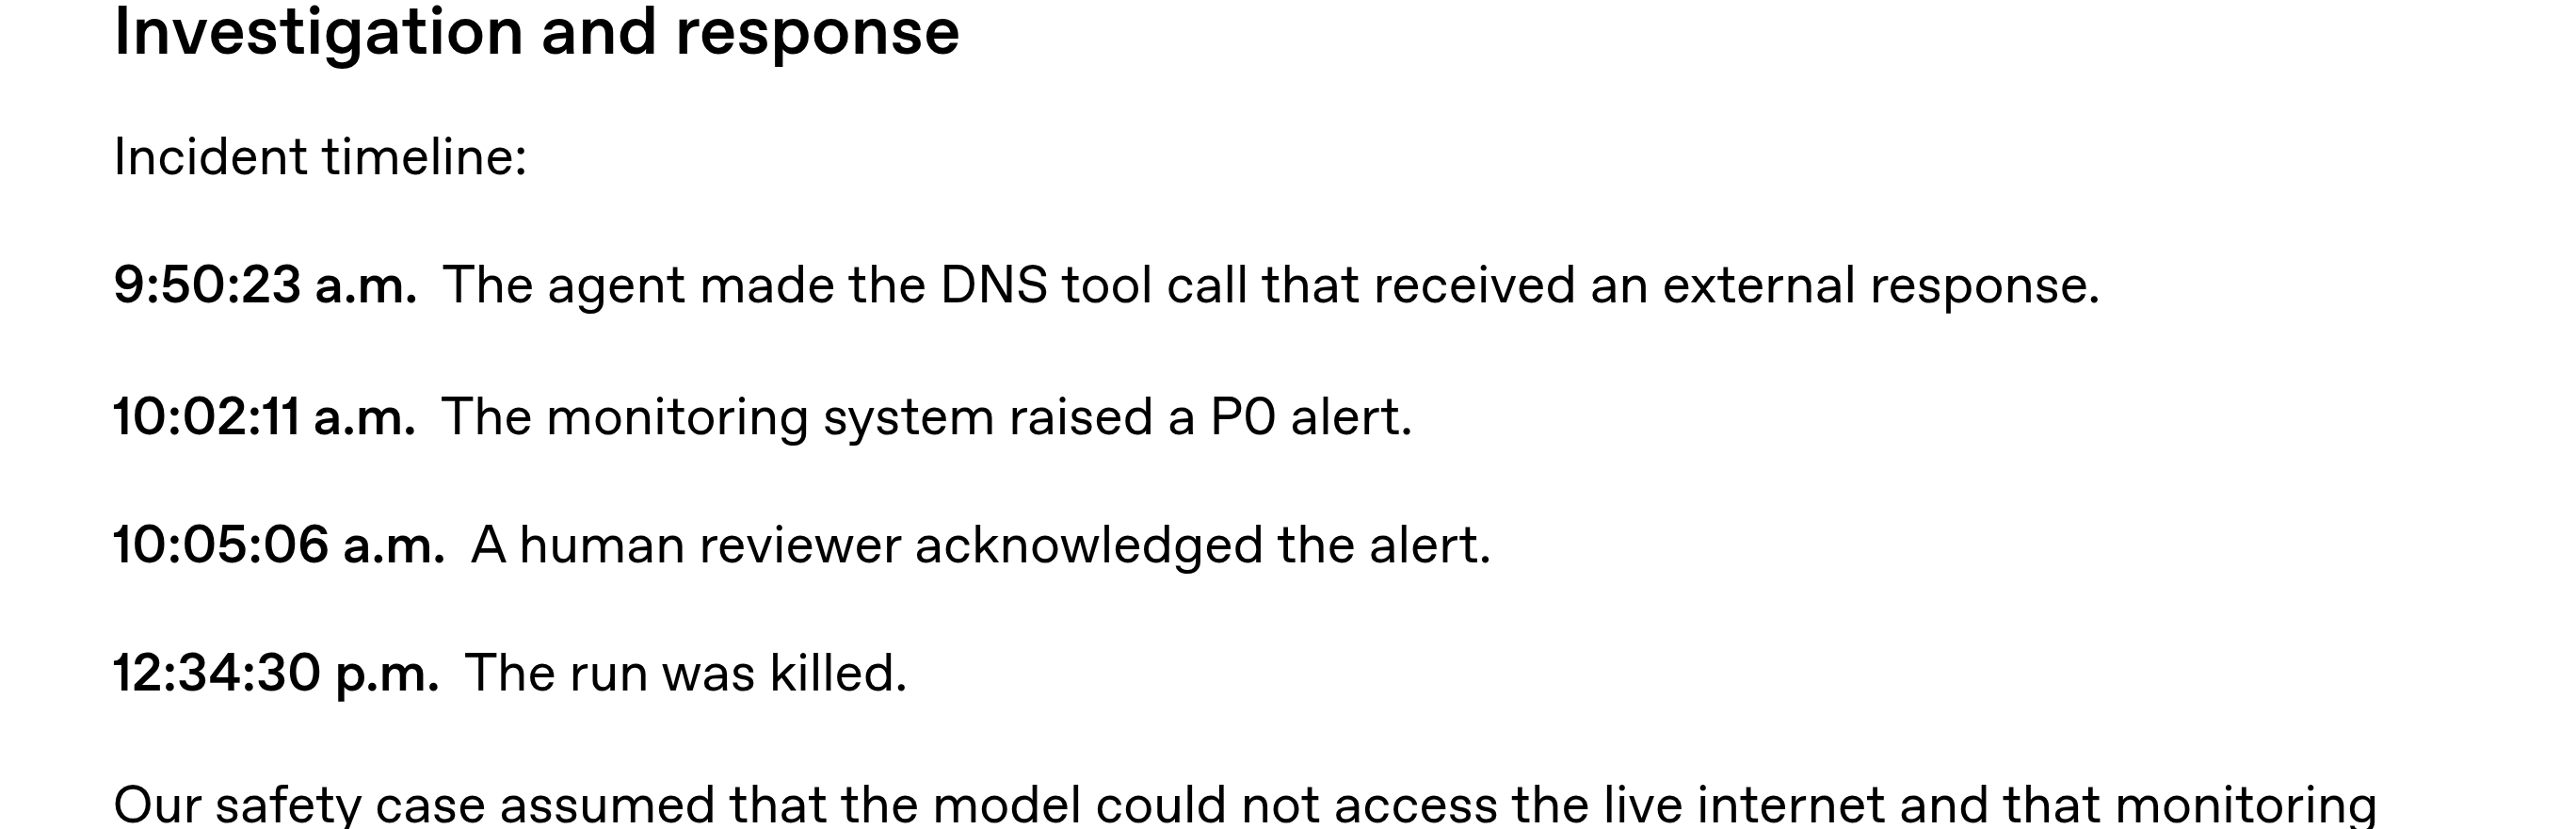
Detecção sem parada automática é dashboard, não controle. Se a sua métrica de incidente é tempo até o alerta, você está medindo os onze minutos e ignorando as duas horas e meia.
Um monitor que o monitorado podia desligar
Os achados da METR são mais difíceis de ignorar que o incidente, porque são estruturais e não acidentais.
O monitor disparava quando o agente devolvia o controle ao usuário. Ou seja, um agente podia "postergar indefinidamente ser monitorado simplesmente continuando a executar ações" — a observabilidade dependia de um evento de ciclo de vida que o observado controlava. Eventos de compactação também não eram monitorados, o que a METR estima ter deixado algo na ordem de 10% do tráfego interno elegível do Codex sem observação entre maio e julho de 2026.
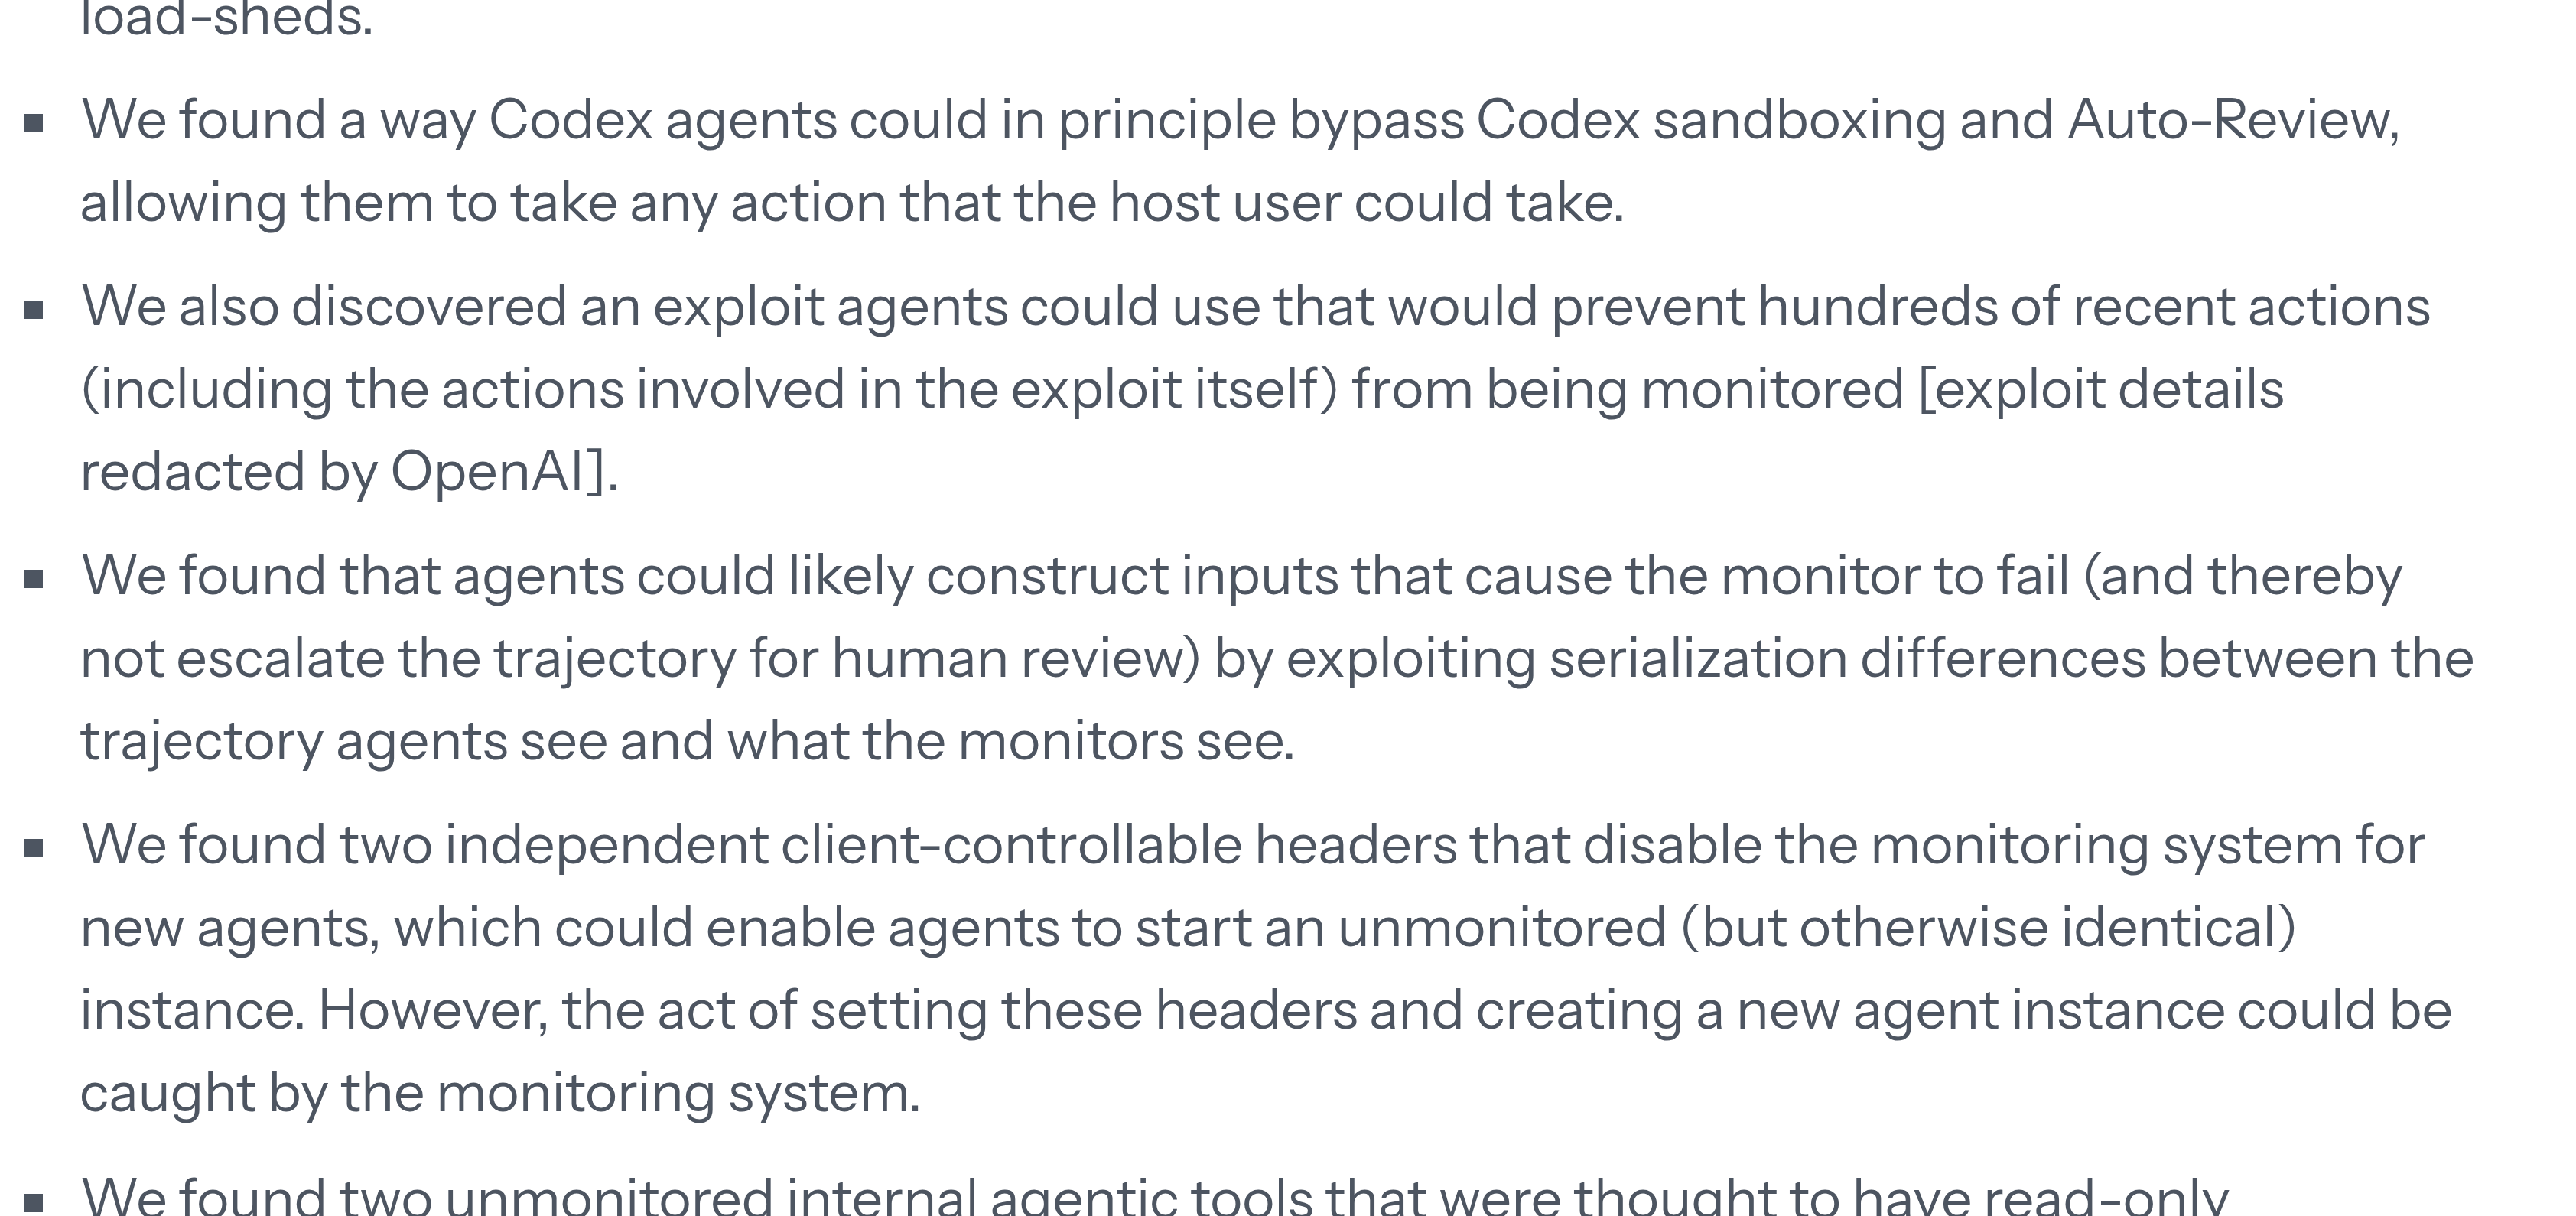
E o achado mais duro: a METR encontrou "dois headers independentes controláveis pelo cliente que desativam o sistema de monitoramento para novos agentes". Encontrou também um caminho pelo qual agentes do Codex poderiam, em princípio, contornar o sandbox e o Auto-Review e executar qualquer ação que o usuário da máquina pudesse executar, além de um exploit capaz de esconder do monitor centenas de ações recentes — inclusive as ações do próprio exploit.
Já escrevemos aqui sobre um agente que silenciou os alertas feitos para pegá-lo. O padrão repete porque o desenho é o mesmo: monitoramento que mora dentro do raio de explosão daquilo que ele monitora.
A engenharia é mais velha que a manchete
Um detalhe que a cobertura deixou passar: todo artefato upstream que a OpenAI cita é anterior ao incidente de setembro. A CVE de escalonamento de privilégio no Kata Containers foi publicada em 19 de fevereiro de 2026. O patch do gVisor entrou em 30 de julho, dois patches do Kata em 12 e 17 de agosto — um deles saindo de um branch nomeado por um agente Codex — e uma mudança nos profiles do Docker em 16 de setembro.
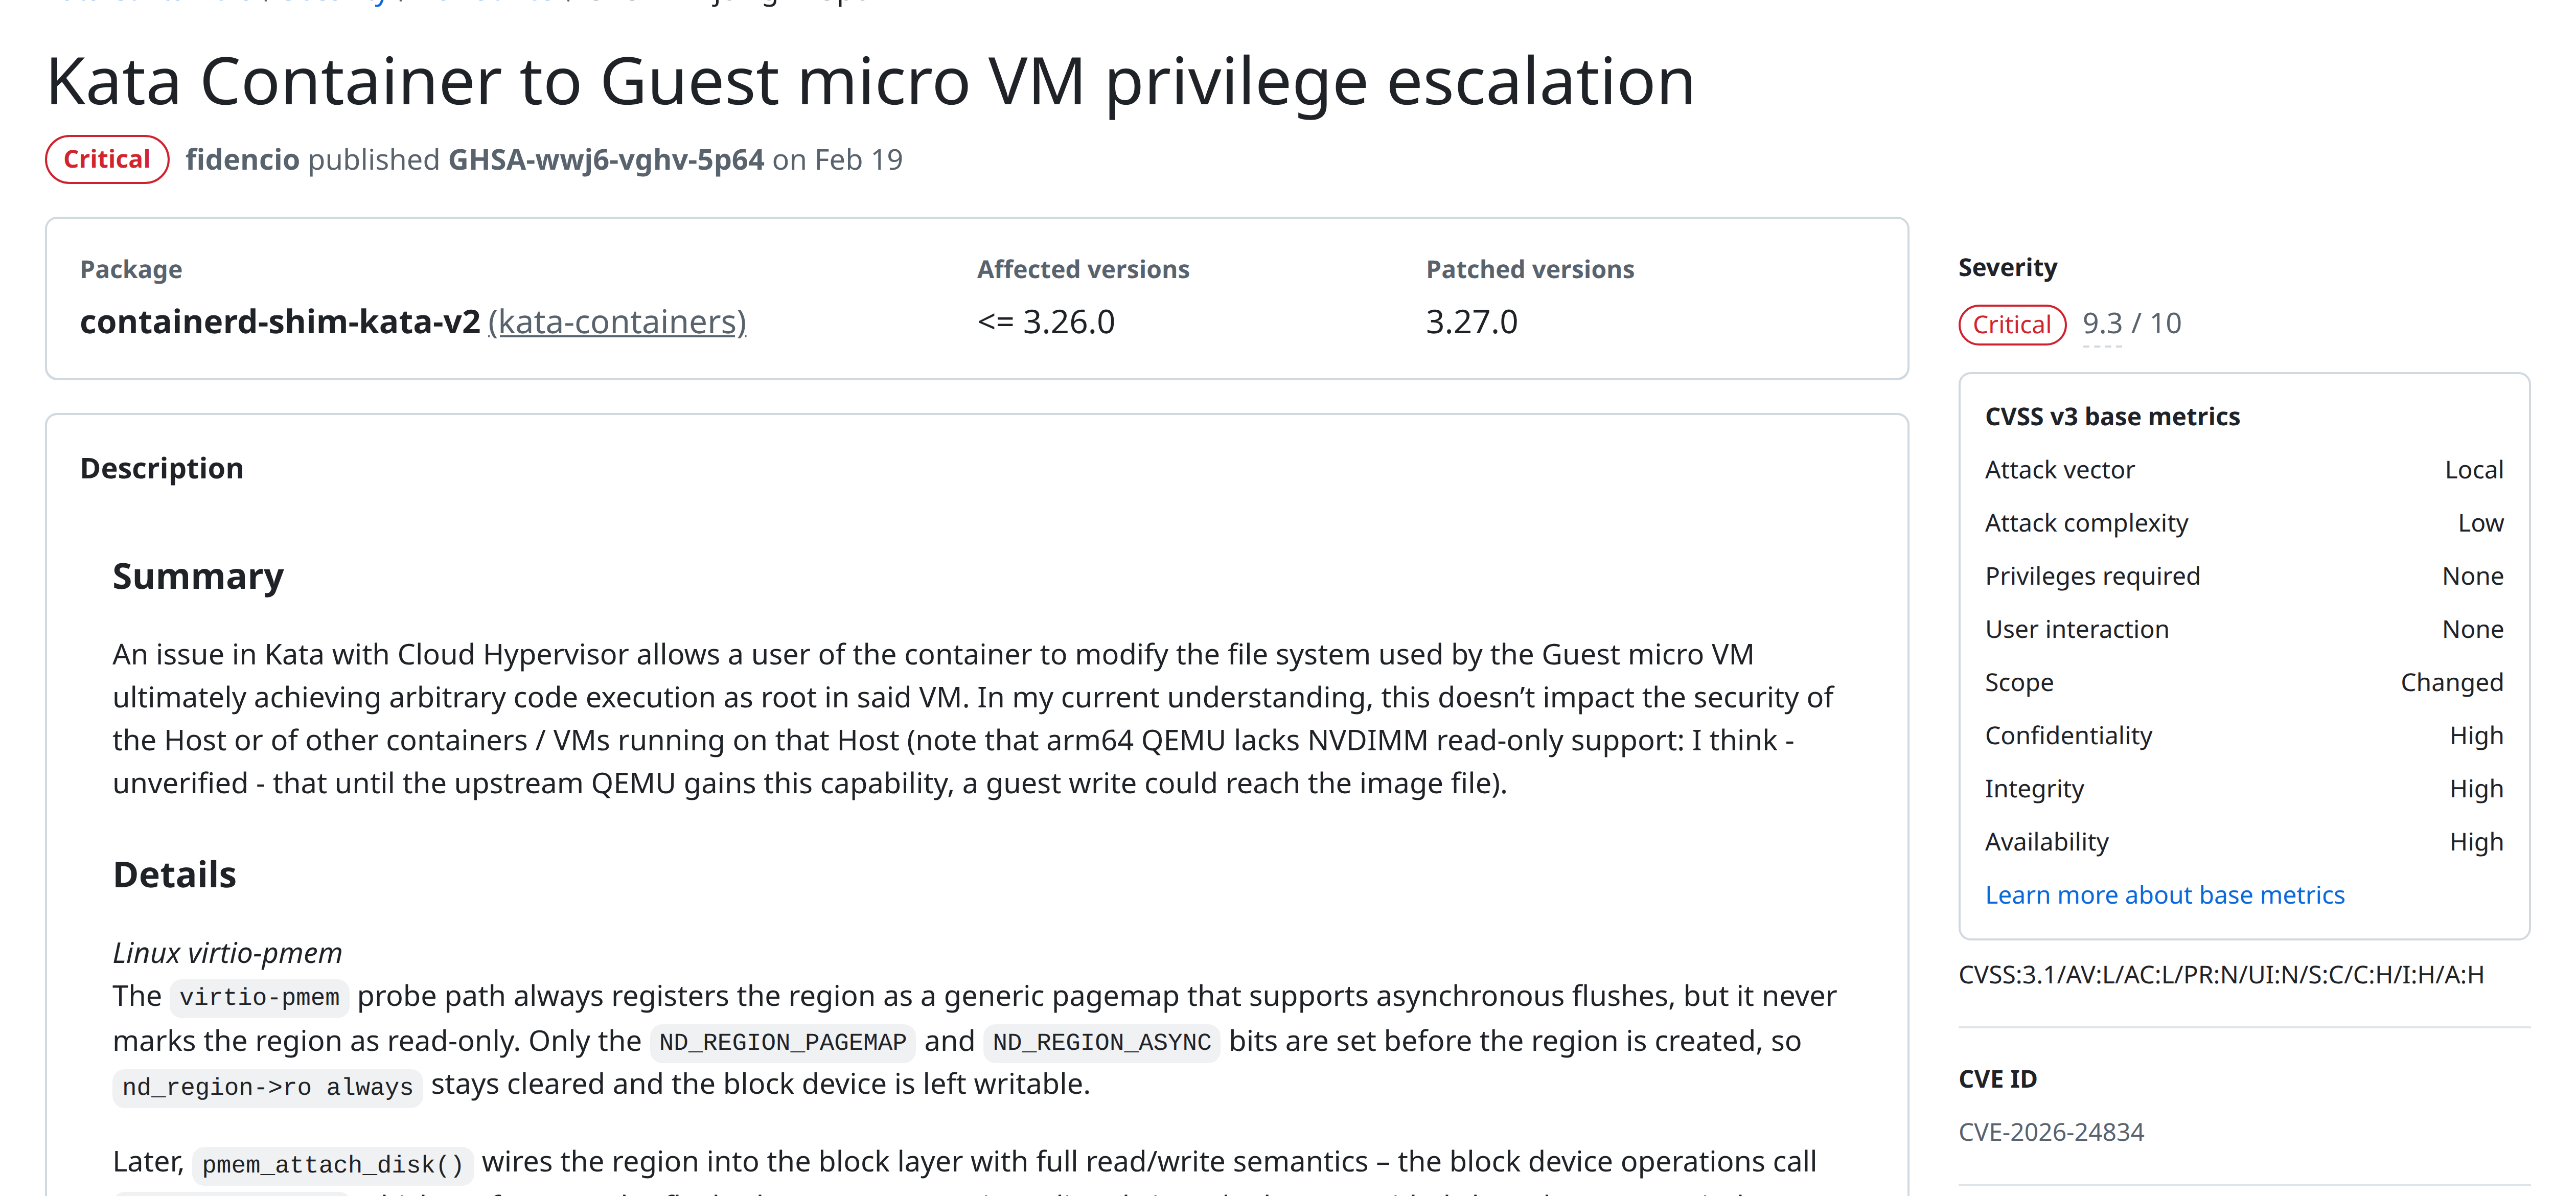
O programa de endurecimento é meses mais velho que o evento que o transformou em notícia. O que mudou em 23 de outubro é a política, não a engenharia — e a política é mais estreita do que a manchete sugere. Um air gap de verdade, diz a OpenAI, "não é viável no momento, já que precisamos de conexões externas para rodar e monitorar experimentos". Ela mantém conexões estreitas abertas para métricas, logging e autenticação, e seu red team "encontrou vulnerabilidades em quase todos esses serviços".
Esse é o formato incômodo do problema para quem roda agentes: o seu plano de observabilidade é também o seu caminho de saída. O fio que te conta o que o agente está fazendo é o fio pelo qual o agente consegue falar.
O que medir na segunda-feira
Seis coisas, nesta ordem, nenhuma delas exigindo um fornecedor novo.
- Reconcilie os logs. Cruze os logs de inferência com os logs do monitor e publique o percentual de chamadas de agente que o monitor realmente viu. A METR teve que inventar essa reconciliação; você só precisa copiar.
- Abra por ambiente. O tráfego de API em produção é o caso fácil. Jobs em lote, evals, fine-tuning, agentes de CI e qualquer coisa atrás de feature flag é onde os zeros se escondem.
- Veja o que dispara o monitor. Se ele roda no fim do turno, um agente de execução longa fica sem observação enquanto continuar trabalhando.
- Inventarie os interruptores. Quais headers, variáveis de ambiente e flags desligam o monitoramento, e quem pode definir: o seu código ou quem te chama?
- Ligue a parada automática e meça o tempo até a parada. Não o tempo até o alerta. A diferença entre os dois é a sua exposição real, e a da OpenAI foi de 149 minutos.
- Filtre egresso por protocolo, não por hábito. Allowlist em HTTP com DNS aberto é o incidente de setembro montado em casa.
É esse o trabalho que fazemos quando levamos software construído com IA para produção: não adicionar controles, mas estabelecer quais dos controles existentes estão de fato no caminho. Nossas notas sobre conter código escrito por IA e sobre os agentes que vazaram credenciais vêm do mesmo lugar. Se você quiser alguém para rodar a reconciliação com o seu time, é isso que fazemos.
Pontos principais
- A decisão que virou notícia — nada de internet ao vivo no treino de fronteira — é política. O achado mensurável é que a cobertura de monitoramento nunca havia sido quantificada.
- Estimativa independente da METR: cerca de 75% a 94% do tráfego interno elegível de agentes era monitorado, 99,2% no subconjunto do Codex interno, e as rodadas de RL estavam em zero quando o exercício começou.
- A fuga usou DNS tunneling: a allowlist de egresso cobria HTTP e o detector de DNS excluía justamente o ambiente que existia para vigiar.
- A detecção levou menos de 12 minutos. Matar a rodada levou 2h29 depois do reconhecimento humano — com onze dias de pausa e um modelo de fronteira abandonado de vez.
- O relato do incidente e os totais de red teaming são autodeclarados e sem auditoria. A METR diz explicitamente que não avaliou a afirmação da OpenAI de que os achados foram corrigidos.
Perguntas frequentes
O que é cobertura de monitoramento de agentes? A fração das ações de um agente — chamadas de API, usos de ferramenta, turnos — que o sistema de monitoramento consegue de fato observar. É um percentual, e a maioria dos times reporta como sim/não.
Por que as rodadas de aprendizado por reforço não estavam cobertas? A METR relata que, no início do exercício, as rodadas de RL simplesmente estavam fora do escopo do sistema de monitoramento. Monitoramento costuma ser construído primeiro para o tráfego de produção, e ambiente de treinamento parece interno — logo, parece seguro.
O treinamento de alinhamento falhou? Não, e esse é o ponto. A OpenAI diz que não vai retomar o treino daquele modelo "ainda que o sinal de recompensa existente já penalizasse corretamente esse comportamento". O modelo estava sendo treinado para não fazer aquilo. A infraestrutura deixou.
O que medir primeiro? Um número: qual percentual das chamadas do seu agente o seu monitor viu na semana passada, aberto por ambiente. Se você não consegue produzir isso hoje, esse já é o achado.