Segurança · Infraestrutura de IA · Risco de Fornecedor
Vazamento em Inferência de IA: 155 É o Número Errado
A Cloudflare vazou 155 respostas de IA entre clientes. O bug não escreve linha de log, então nenhum provedor consegue auditar a exposição.
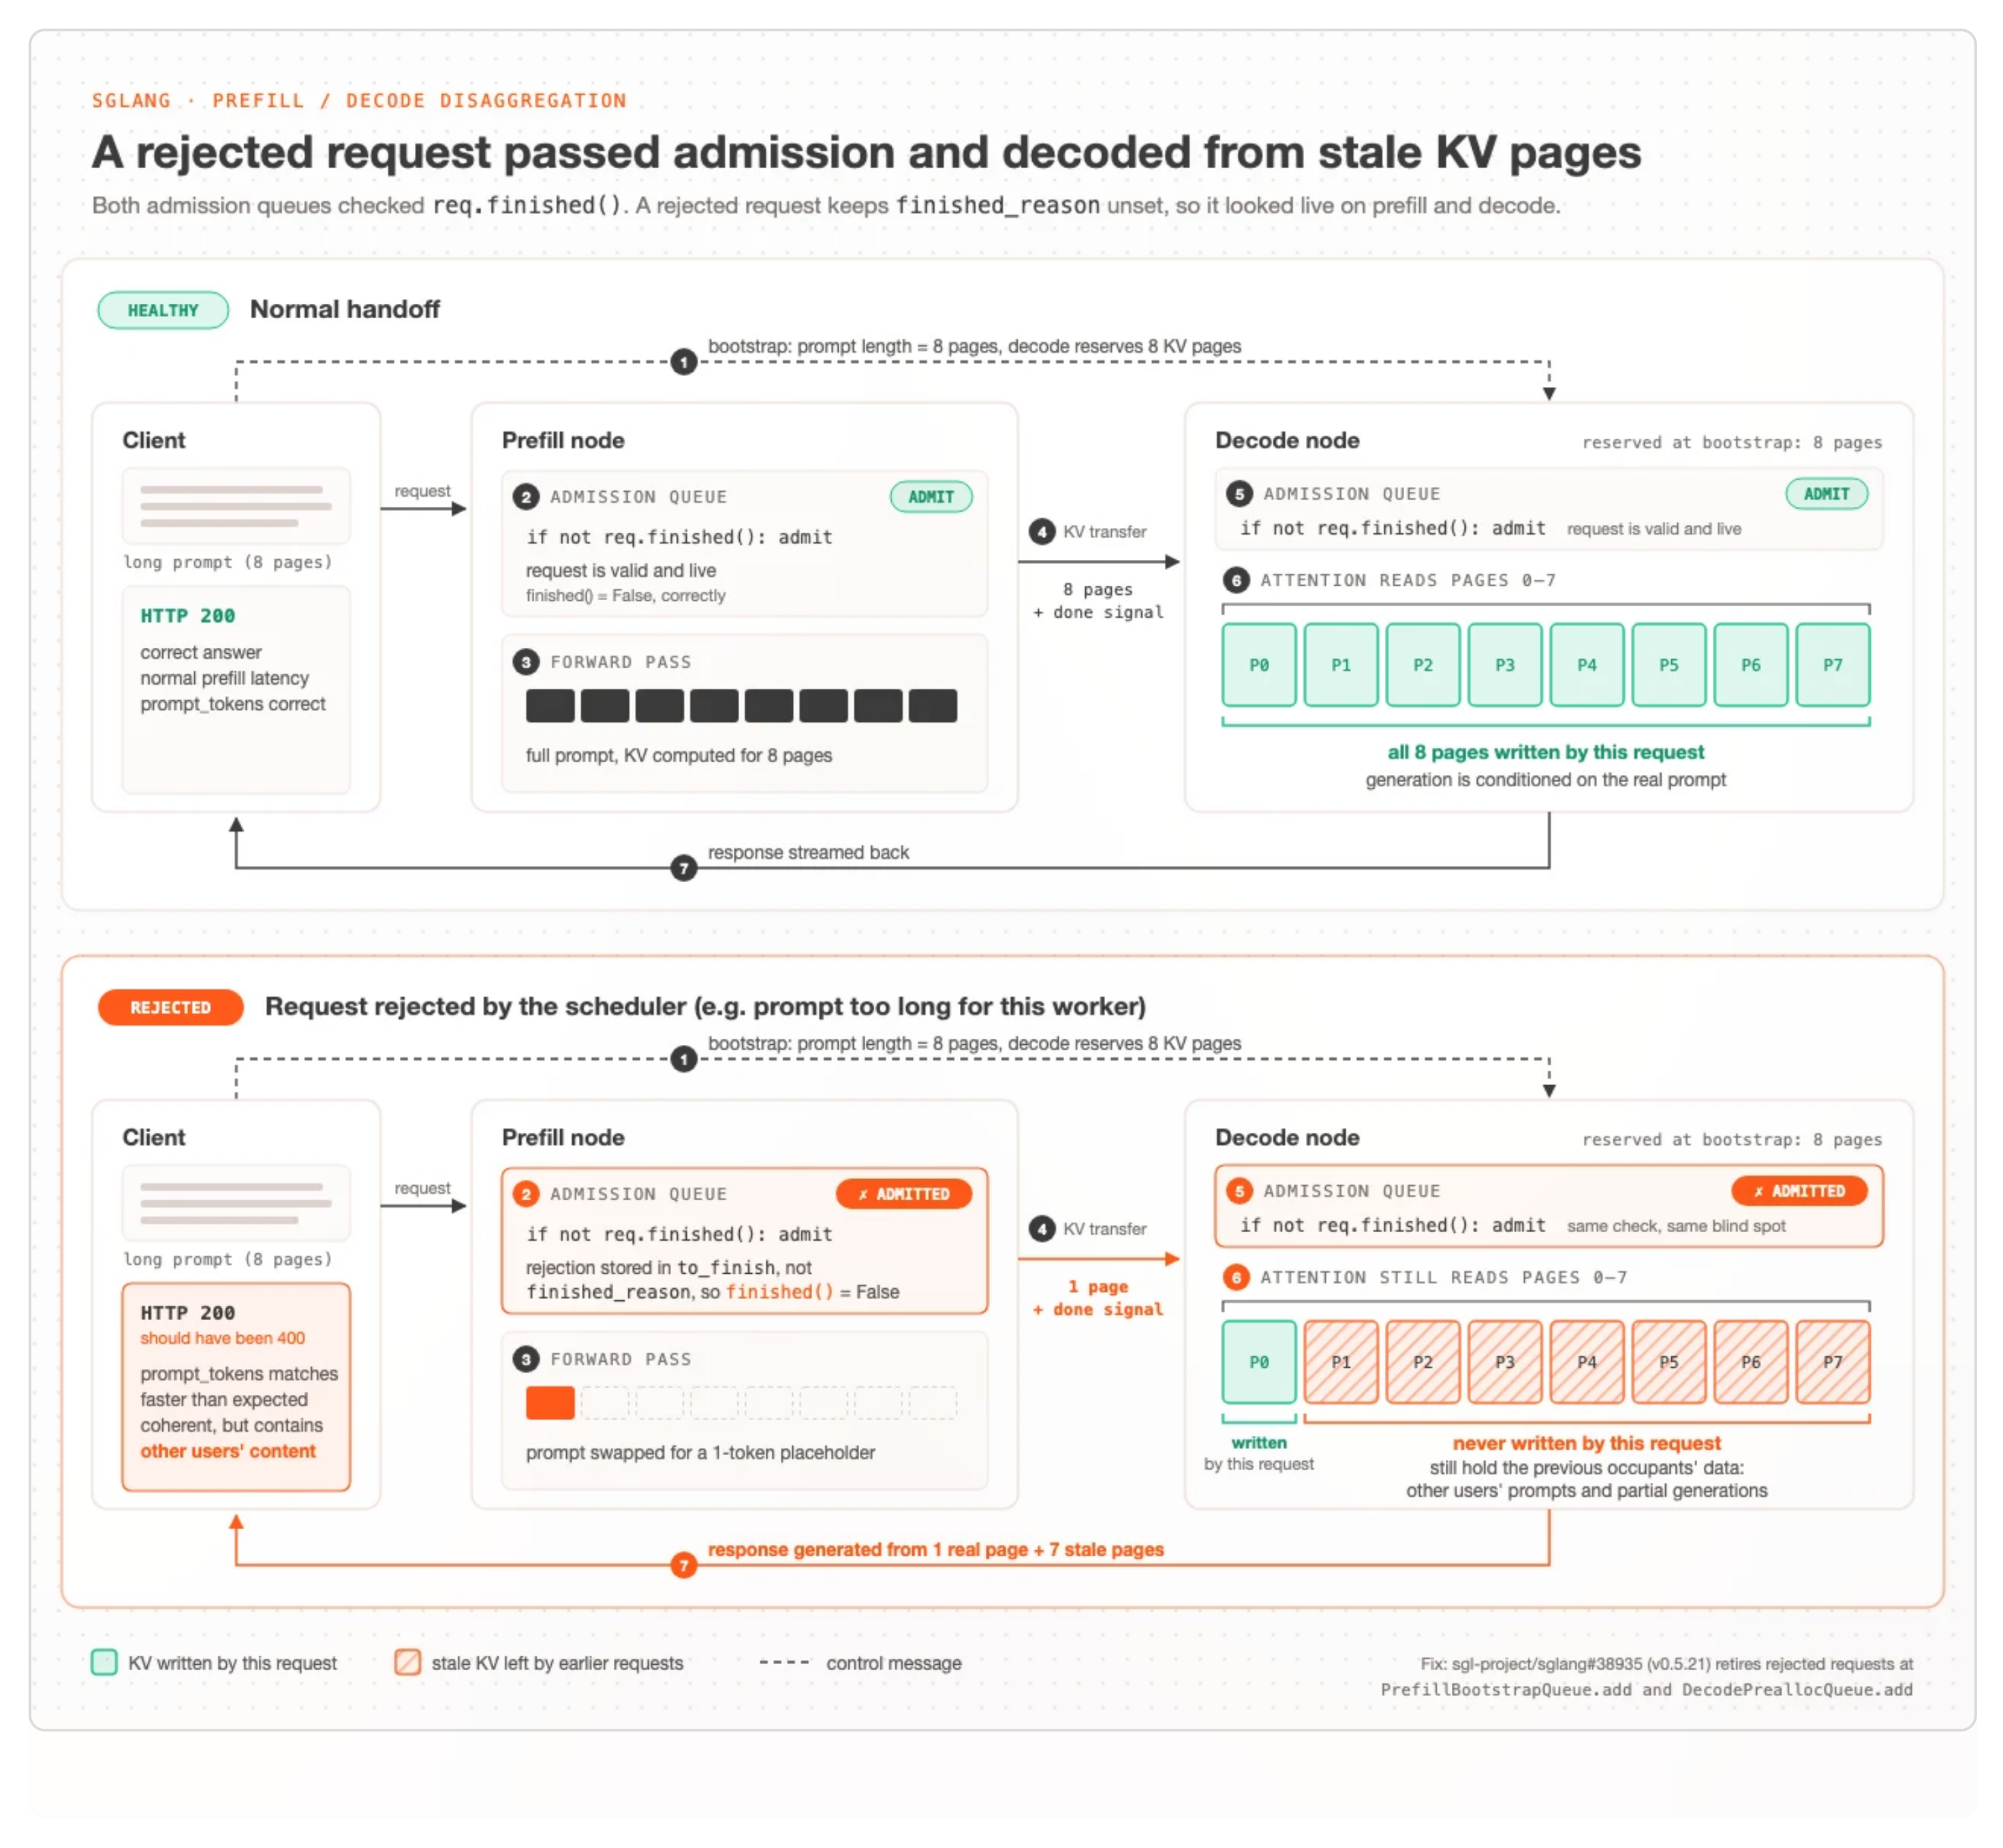
A Cloudflare divulgou que 155 respostas da sua plataforma Workers AI voltaram carregando pedaços de prompts e gerações de outros clientes. O número é pequeno, é preciso, e é o dado menos útil de toda a divulgação — porque o defeito que o produziu não gera erro e não escreve nenhuma linha de log. 155 é a quantidade de vazamentos que a Cloudflare conseguiu deduzir pelo formato das suas requisições, não a quantidade que aconteceu. Para essa classe de falha, nenhum provedor de inferência hospedada consegue dizer depois do fato se os seus prompts terminaram dentro da resposta de outra pessoa.
Se a sua empresa revende uma funcionalidade de IA, você é o controlador perante o seu cliente final. O contrato que você assinou promete isolamento entre clientes. A notificação que a LGPD espera de você em caso de incidente precisa de evidência — e é exatamente a evidência que não existe nessa falha. Essa é a frase para levar para a próxima conversa com fornecedor, e ela tem muito pouco a ver com a competência da Cloudflare.
O que foi verificado aqui, e o que é a palavra do fornecedor
Este texto é feito de dois tipos de afirmação, e misturar os dois o tornaria menos útil.
Verificado de forma independente, contra a API do GitHub e o próprio comunicado de segurança dos mantenedores do motor: as datas, o relato público do bug sete semanas antes do lançamento, o histórico de releases e a afirmação de que a corrupção não deixa rastro. Isso é registro público, e nós lemos por conta própria em 27 de outubro de 2026.
Relatado pela Cloudflare sobre a Cloudflare, sem nenhuma parte externa capaz de confirmar ou limitar: a contagem de 155; que toda requisição afetada tinha prompt maior que 681.280 tokens; que nenhum outro modelo do Workers AI foi afetado; que não há "evidência de exploração deliberada"; e a linha do tempo da resposta ao incidente. A Cloudflare é a única parte que tem esses logs. E pelo mecanismo descrito no post da própria Cloudflare, esses logs não conseguem mostrar o vazamento diretamente — então 155 é um piso deduzido do formato das requisições, não uma medição. Ler esse número como teto é o erro de que este post trata.
Dizer isso não é alfinetar a divulgação. O post da Cloudflare é incomumente franco, inclusive sobre os próprios testes. É uma afirmação sobre qual evidência existe.
A assinatura da falha: todos os sinais estavam verdes
O modelo era o @cf/zai-org/glm-5.3, servido com prefill e decode separados em nós distintos — o nó de prefill calcula o cache de chave-valor do prompt, envia pela rede, e o nó de decode gera a partir dele. Uma requisição com prompt longo demais para o worker de prefill foi rejeitada pelo escalonador. A rejeição foi gravada no campo errado, então as duas filas de admissão checaram req.finished(), viram False, e deixaram passar como se a requisição estivesse viva.
O nó de prefill então trocou o prompt por um placeholder de um token e transferiu uma única página de cache. O nó de decode já tinha reservado oito. A atenção leu as oito assim mesmo. Sete delas ainda guardavam o que os ocupantes anteriores tinham deixado ali: prompts e gerações parciais de outros clientes.
O que o cliente recebeu foi um HTTP 200 que deveria ter sido 400, uma contagem de prompt_tokens batendo com o prompt real, latência melhor que a esperada, e uma resposta coerente e bem formada.
O diagrama da própria Cloudflare. A requisição rejeitada passa pelas duas filas, uma página real é escrita, e a atenção lê as oito. O cliente recebe HTTP 200 e uma resposta fluente montada com sete páginas de dados de outra pessoa. Fonte: Cloudflare.
Essa é a parte que a cobertura repetiu sem desenvolver. Num sistema CRUD comum, ler memória não inicializada produz um crash, um nulo, um stack trace — algo que uma asserção pega. Num modelo de linguagem, uma leitura corrompida produz texto fluente, porque o decodificador segue alegremente a partir de quaisquer bytes que estejam na janela de atenção. A falha não se anuncia. Ela renderiza.
Por que os testes passaram
A Cloudflare declara a lacuna com as próprias palavras, e é a frase mais aproveitável do post (tradução nossa):
Essa foi uma lacuna crítica nos nossos testes: validamos apenas códigos de resposta HTTP e desempenho do motor em contextos longos, sem validar a saída e a coerência do modelo.
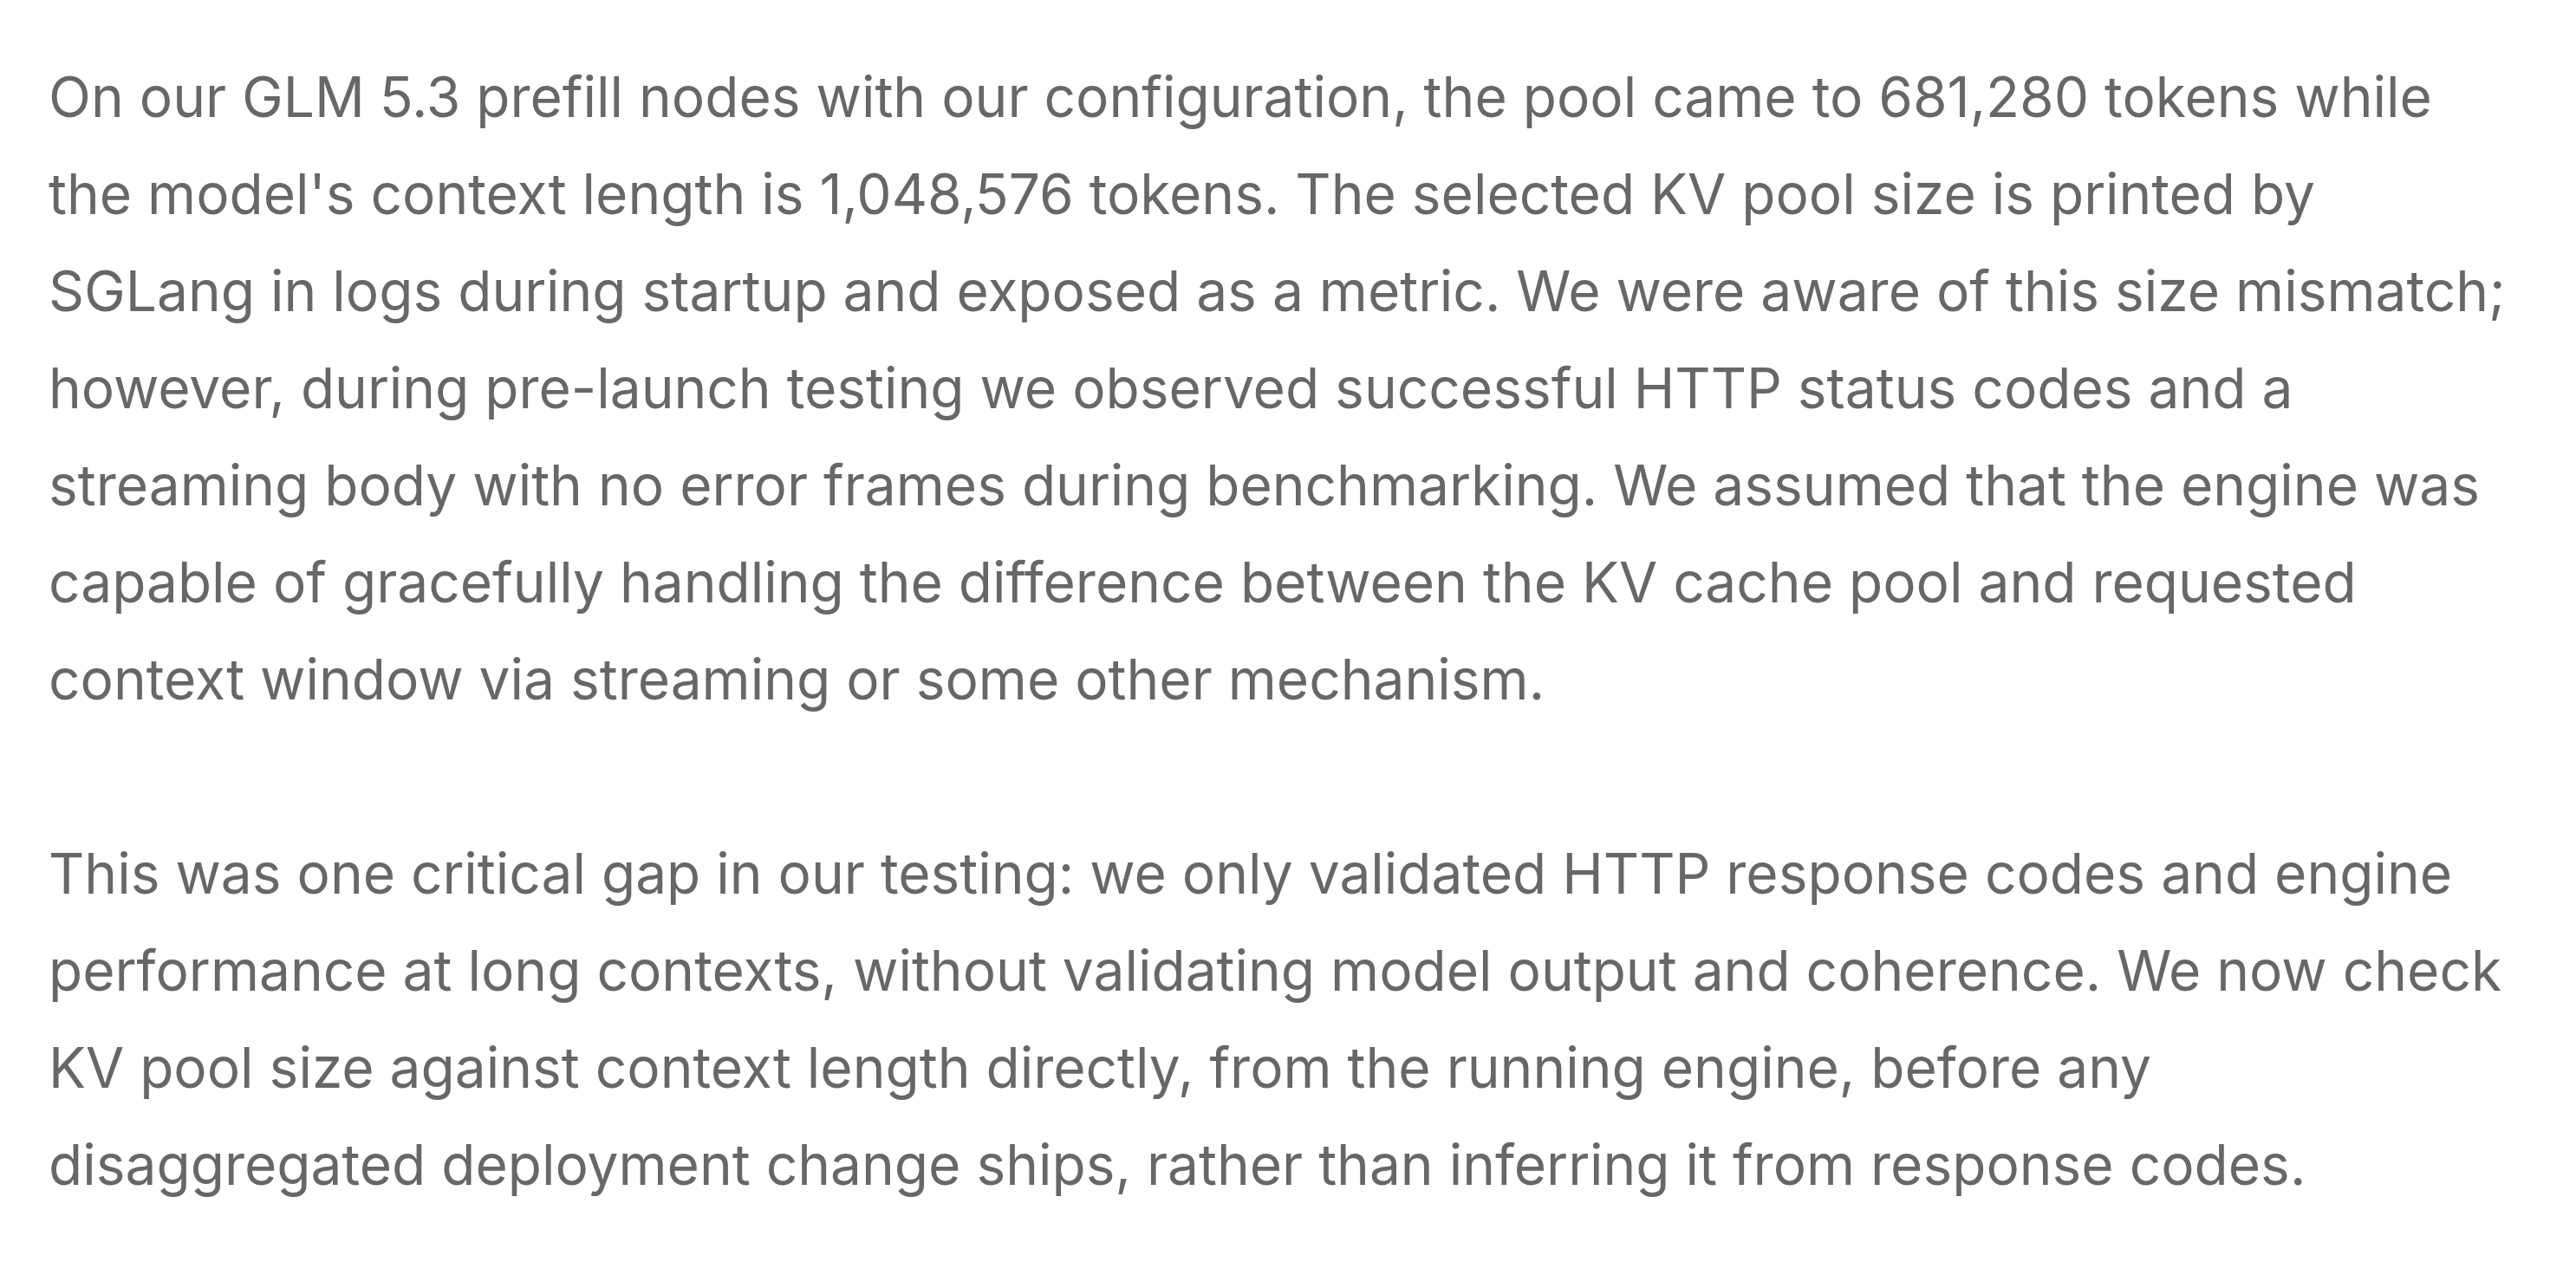
A admissão que transforma isso num problema de todo mundo, e não da Cloudflare. O time sabia que o pool de cache era menor que a janela de contexto anunciada e lançou mesmo assim, porque os testes voltaram verdes — e os testes afirmavam sobre status code. Fonte: Cloudflare.
Leia como lição de projeto, não como confissão. Teste de aceitação baseado em status code e smoke test é adequado para uma API REST. Contra um motor de inferência ele é estruturalmente cego, porque o modo de falha do sistema é um 200 com boa prosa. A cegueira é propriedade da arquitetura, não do zelo de alguém — e é exatamente por isso que os seus testes também a têm.
O bug era público sete semanas antes do lançamento
Aqui está a parte que ninguém mais checou. O defeito exato foi registrado no GitHub como sgl-project/sglang#30233 em 6 de julho de 2026 — 52 dias antes de a Cloudflare lançar o GLM 5.3 no Workers AI, em 27 de agosto. Não é uma reclamação vaga: nomeia set_finish_with_abort, o truncamento para um token e o lado de decode lendo slots de cache não inicializados, em seis passos, com patch funcional e receita de reprodução. O bloco de ambiente lista a mesma família de modelo, o mesmo backend de transferência e o mesmo contexto de um milhão de tokens da implantação da Cloudflare.
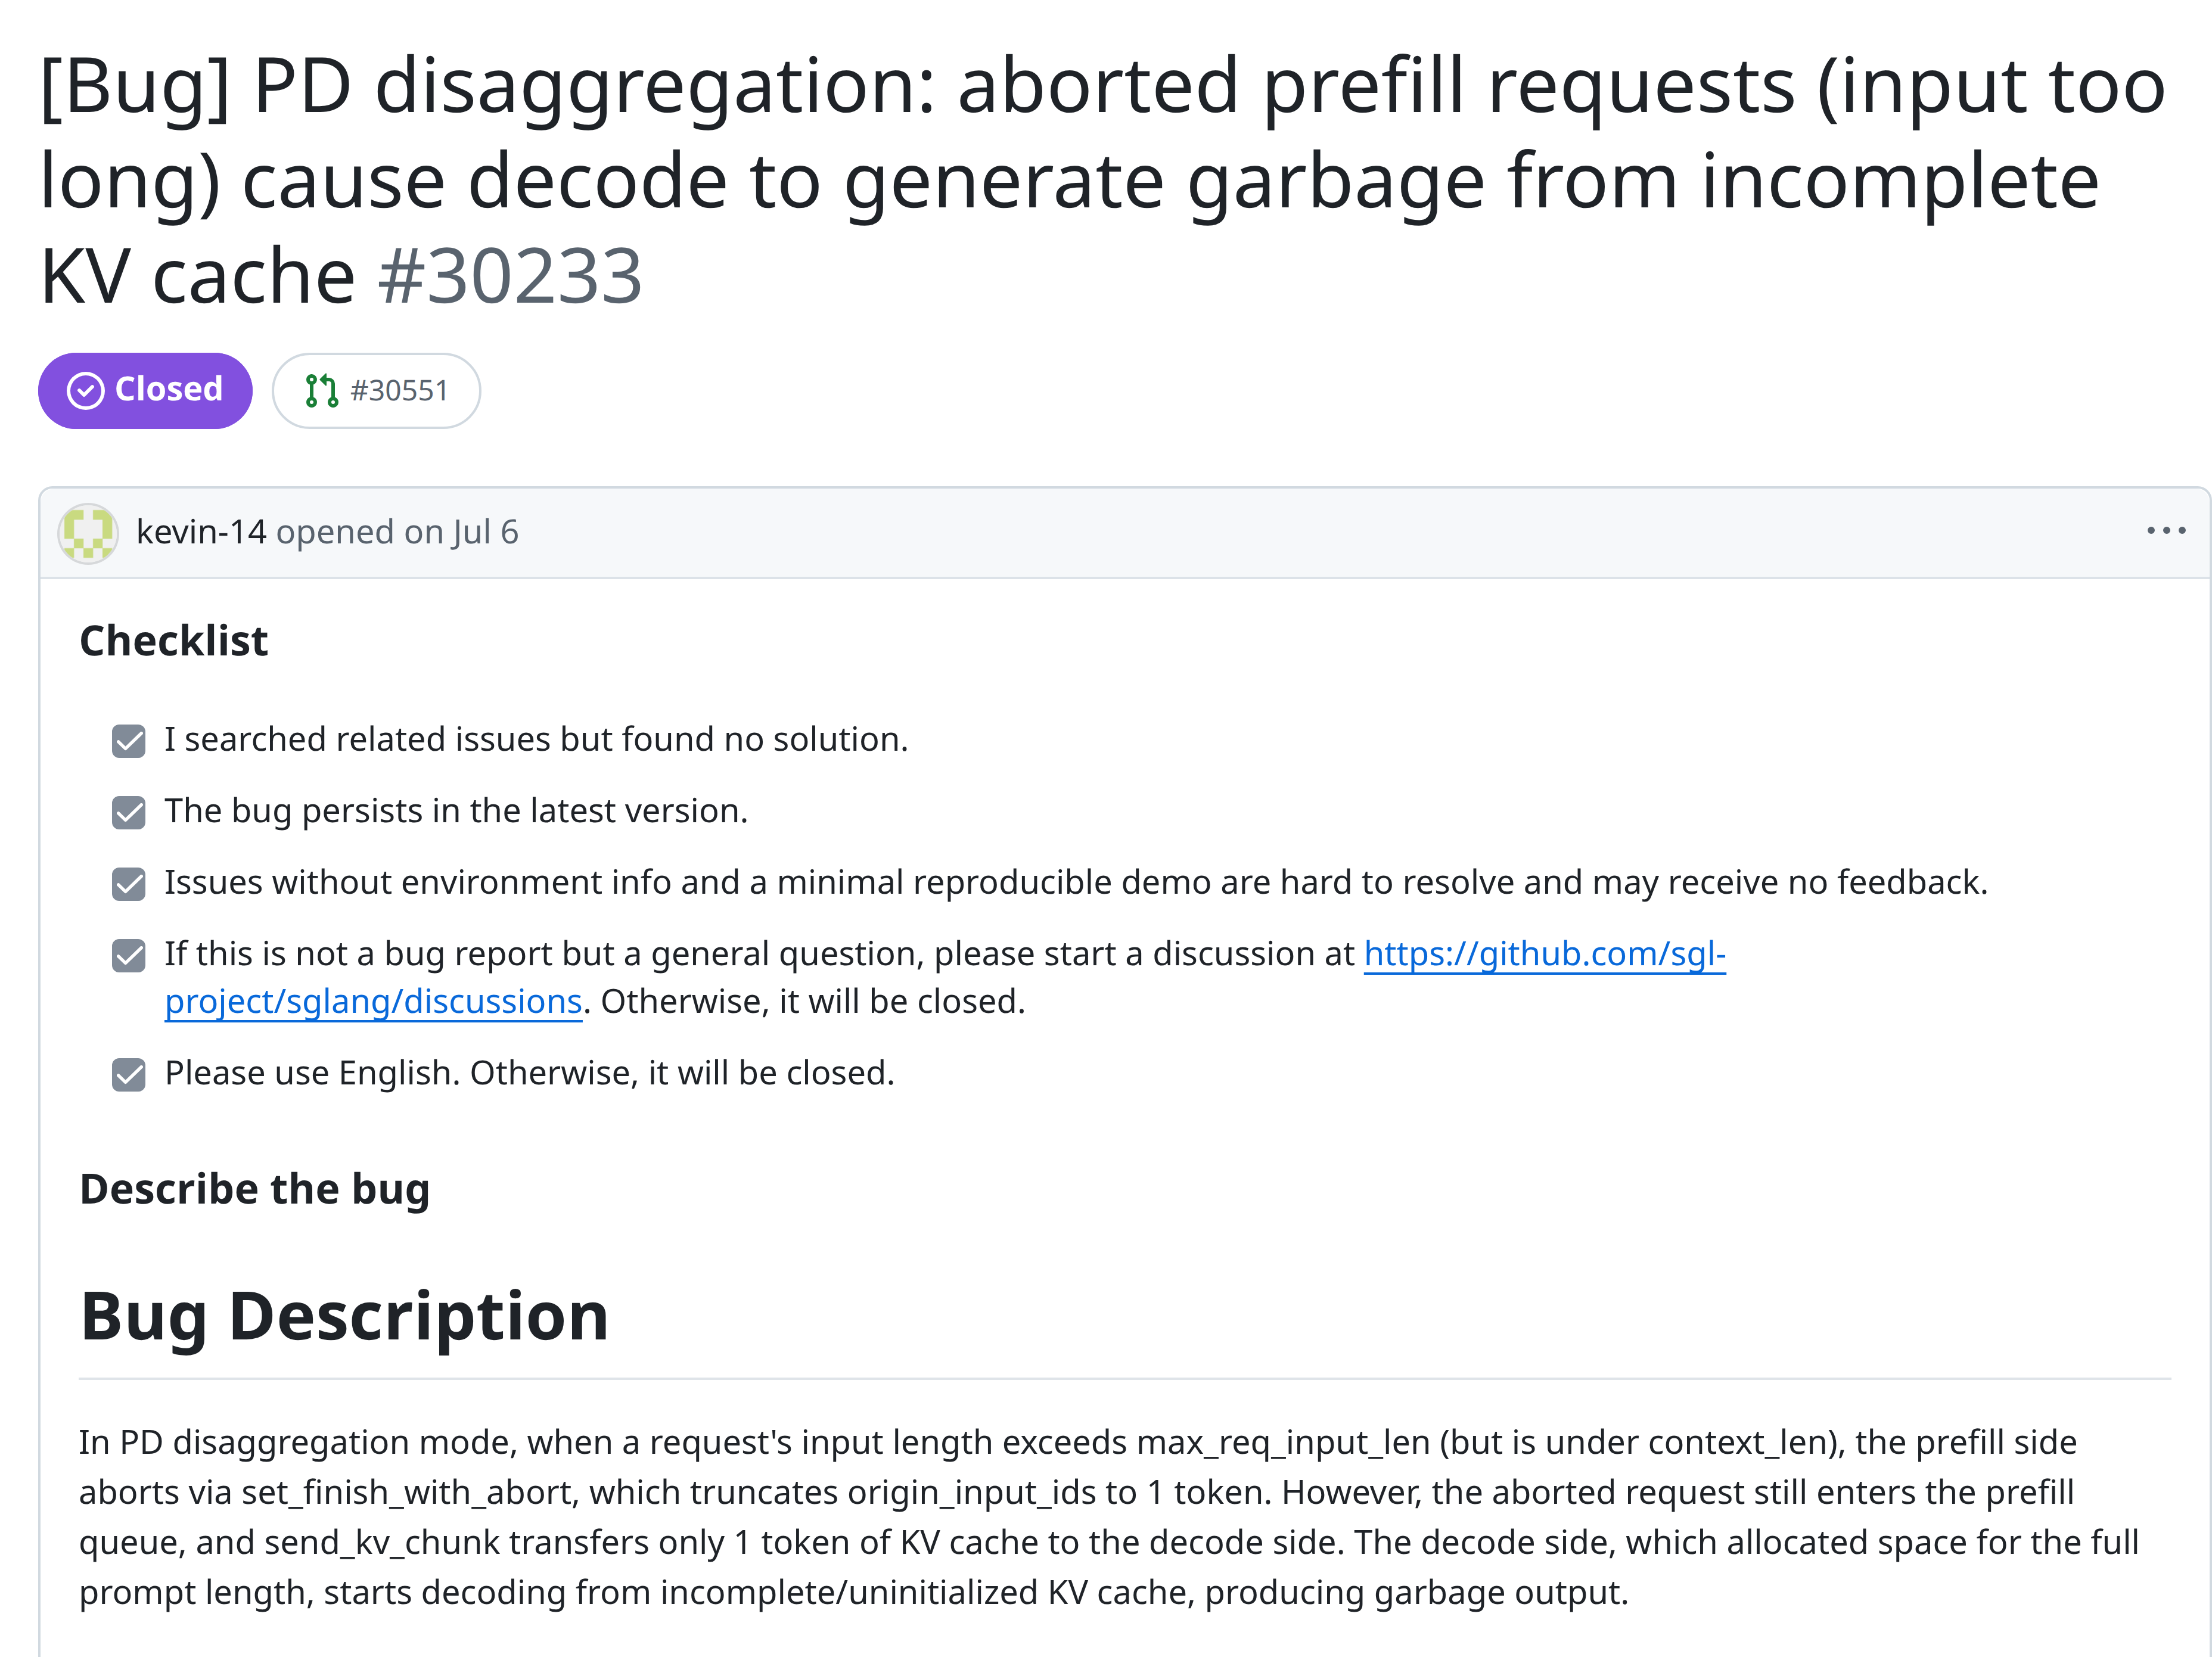
Issue #30233, 6 de julho de 2026. A causa raiz está completa e correta. O sintoma foi registrado como saída lixo — as mesmas páginas de cache não inicializadas que a Cloudflare teria depois de reportar como dados de outros clientes. Fonte: github.com/sgl-project/sglang.
O título chama aquilo de "garbage output", saída lixo. As palavras vazamento, tenant e segurança não aparecem em lugar nenhum. O passo quatro da reprodução diz: "decode retorna conteúdo lixo não relacionado à entrada."
Mesma memória não inicializada. Dois leitores. Um registrou um defeito de qualidade; o outro teve que declarar um incidente de dados. A severidade foi decidida por quem leu o sintoma, não pelo bug.
E a issue não foi fechada por uma correção. Um bot de inatividade fechou como completed e aplicou o rótulo inactive em 4 de setembro — quatro dias antes de o relato de segurança do pesquisador Gadi Evron, da Knostic, chegar à Cloudflare via HackerOne, em 8 de setembro.
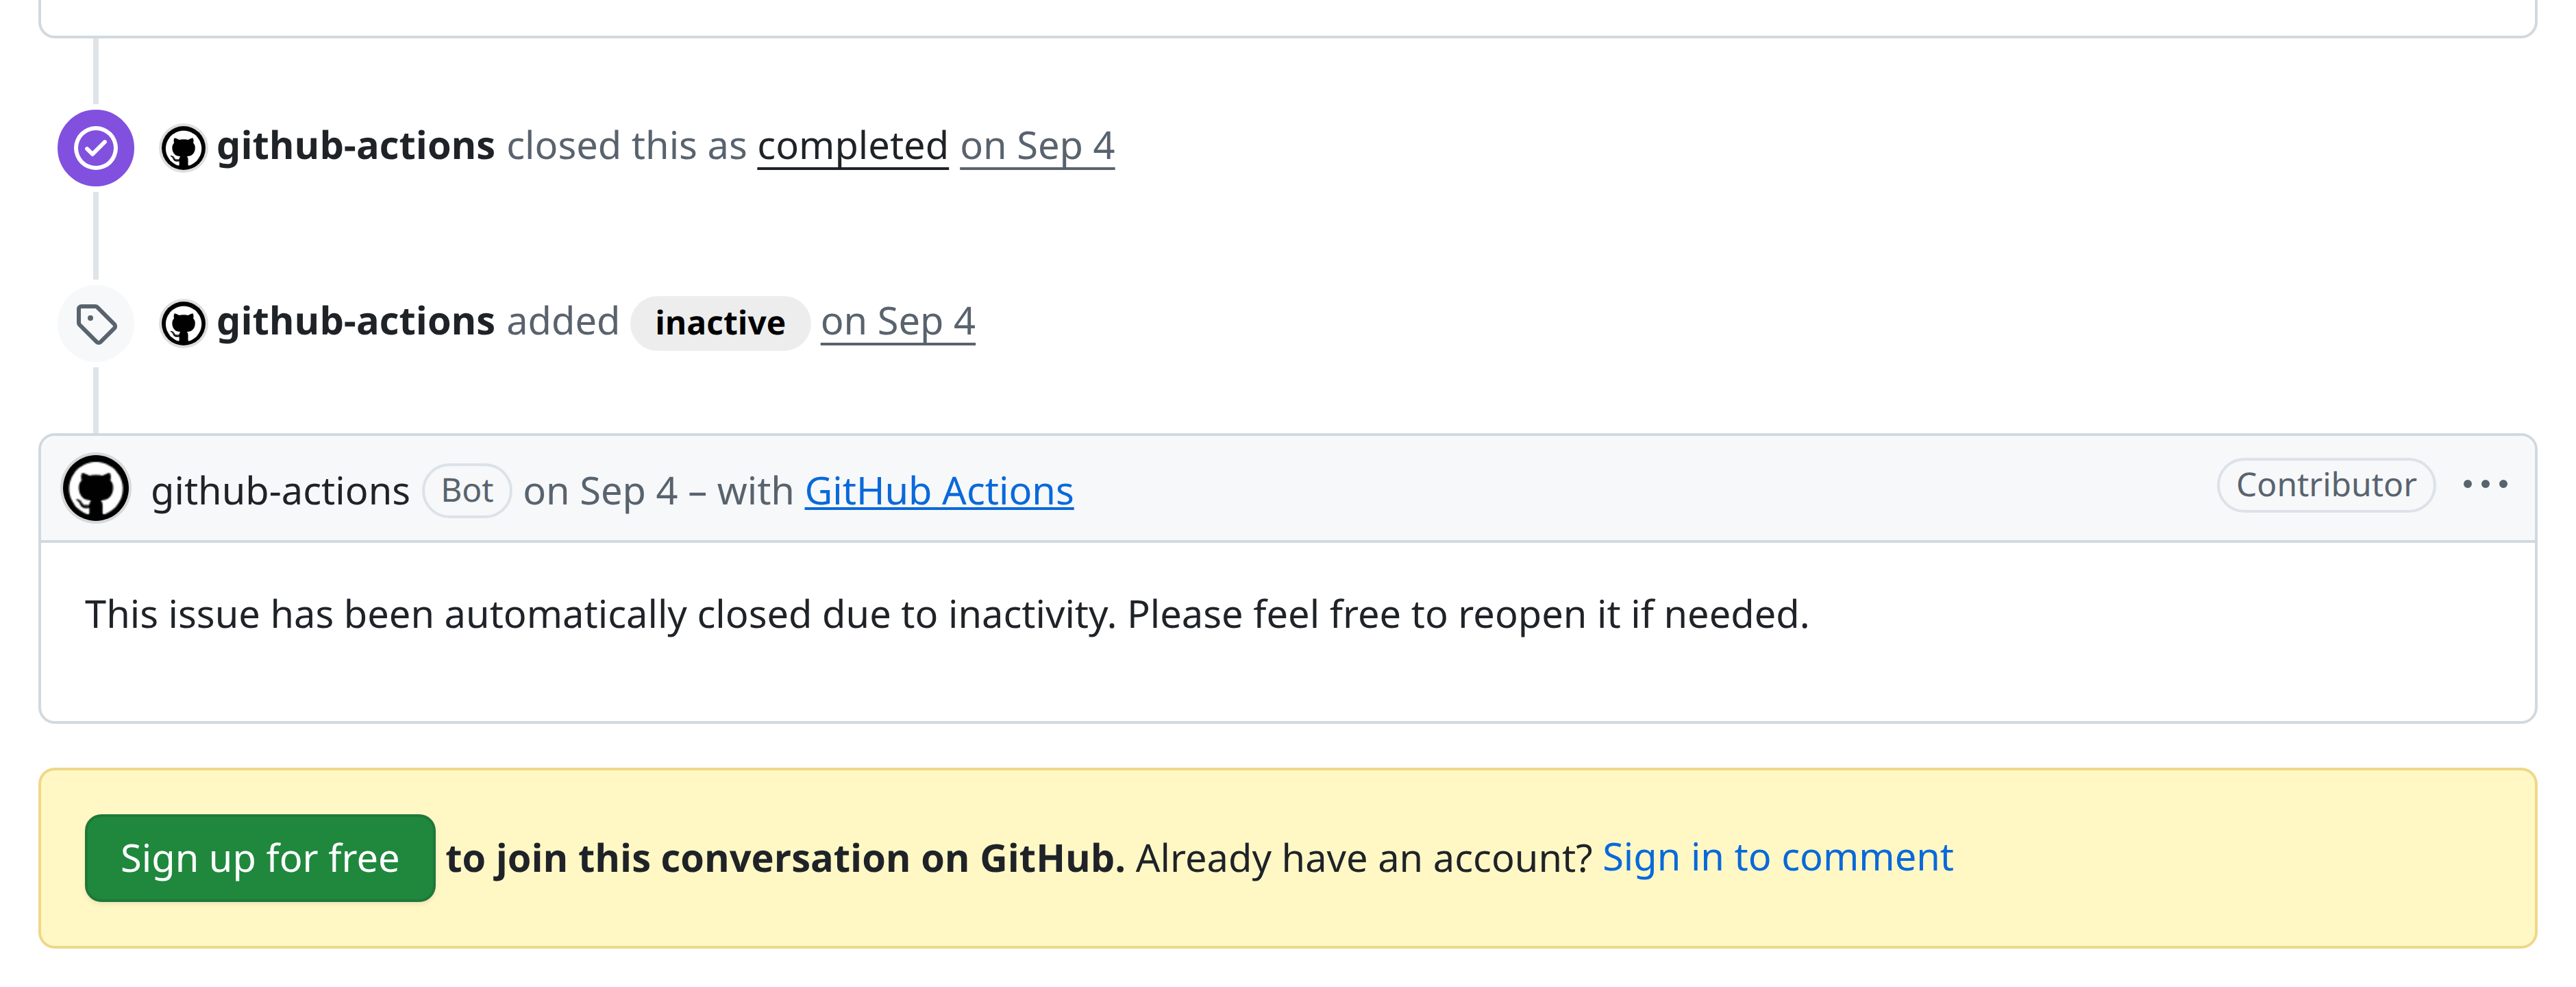
Nenhum humano fechou. Um bot de inatividade marcou como concluído o relato público desse bug em 4 de setembro; o relato de segurança chegou em 8 de setembro. Fonte: github.com/sgl-project/sglang.
Os dois números que valem mais que 155
Os mantenedores do motor publicaram um comunicado coordenado junto com o da Cloudflare. Sobre a condição de corrida correlata, de transferência abortada — mesma assinatura, gatilho diferente — ele afirma que, em implantações desagregadas, as configurações padrão estiveram afetadas da linha v0.4.x no começo de 2025 até a v0.5.21, em 2 de outubro de 2026. Mais de dezoito meses, ligado por padrão, em todo mundo que roda essa topologia.
Em seguida vem a frase que deveria reposicionar a forma como você lê qualquer aviso de incidente vindo de um fornecedor de IA (tradução nossa):
Quem opera não tem forma confiável de saber [se a exposição já ocorreu], porque a corrupção não deixa erro nem linha de log.
As duas frases que valem mais que o número da manchete: configurações padrão afetadas desde o começo de 2025, e nenhuma forma confiável de qualquer operador determinar depois do fato se houve exposição. Fonte: SGLang / LMSYS.
A correção que fecha o caminho ligado por padrão mediu −0,38% de throughput, com intervalo de confiança cruzando o zero. Ou seja: a propriedade de isolamento não foi trocada por velocidade que alguém pudesse medir. Ela simplesmente ficou desligada por padrão durante um ano e meio, porque ninguém ainda a tinha enquadrado como propriedade de segurança.
O que significa que "não encontramos evidência de exposição" é uma afirmação sobre a ausência de instrumentação, não sobre a ausência de vazamento. As duas coisas podem ser verdade ao mesmo tempo. Só uma delas é o que o comprador entende.
Três coisas para fazer na segunda-feira
Não são opiniões — são decisões, na ordem em que custam dinheiro.
- Pergunte ao seu provedor de inferência, por escrito, qual motor e qual versão ele roda, se usa desagregação prefill/decode, e se os checksums de transferência estão habilitados. Você assinou um contrato prometendo isolamento ao seu cliente. Se o provedor não sabe dizer a versão, ele não consegue dizer se esteve dentro daquela janela — e a obrigação continua sendo sua de qualquer jeito.
- Faça os testes de aceitação afirmarem sobre o conteúdo da saída, não sobre o status code, antes de qualquer coisa com formato de IA entrar no ar. Uma checagem de saída de referência, uma asserção de coerência, um prompt canário cuja resposta você conhece — qualquer coisa que perceba uma resposta fluente e errada. Um 200 não é aprovação.
- Orçamente instrumentação em vez de garantia. "Sem evidência de exposição" deveria soar para você como item de orçamento, não como atestado de saúde. Se um vazamento na sua stack não deixaria rastro, é isso que se conserta primeiro, antes do vazamento que você ainda não teve.
A mesma disciplina que aplicamos para conter código escrito por IA vale para a IA que o serve, e escrevemos sobre um agente que silenciou os próprios alertas de segurança pelo mesmo motivo. Em sistemas de IA, o formato padrão de uma falha é uma resposta confiante e bem escrita. Correção tem que ser afirmada sobre conteúdo, ou não está sendo afirmada. É disso que o nosso trabalho de produção é feito, na maior parte.
Pontos principais
- As 155 respostas afetadas são um piso deduzido de logs de requisição, não um total medido. Nenhuma parte externa consegue confirmar ou limitar o número.
- O bug produziu HTTP 200, contagem de tokens batendo, latência menor que a esperada e prosa coerente. Todo sinal sobre o qual um teste competente afirma estava verde.
- A mesma classe de defeito esteve na configuração desagregada padrão do motor de inferência do começo de 2025 até 2 de outubro de 2026.
- A corrupção não deixa erro nem linha de log, então nenhum operador — Cloudflare incluída — consegue provar retroativamente que os prompts de um cliente não vazaram.
- A correção custa −0,38% de throughput, dentro do ruído de medição. Isso nunca foi um trade-off de desempenho.
Perguntas frequentes
Meus dados vazaram? Se você usou o GLM 5.3 no Workers AI entre 27 de agosto e 9 de setembro de 2026 com prompts acima de cerca de 681 mil tokens, a Cloudflare pode dizer se você estava no conjunto que ela deduziu. Fora disso, e para qualquer outro provedor rodando serving desagregado, a resposta honesta é que ninguém consegue estabelecer isso em nenhuma direção — que é justamente o ponto deste post.
Isso é problema da Cloudflare ou do SGLang? De nenhum dos dois, de forma útil. O bug de admissão está no motor; a decisão de lançar com um pool de cache menor que a janela de contexto anunciada foi da Cloudflare; o padrão de teste que deixou passar é do setor inteiro. A Cloudflare é um dos poucos provedores que publicou detalhe suficiente para sequer poder ser criticado.
Isso afeta inferência em nó único? A condição de corrida específica de transferência abortada exige desagregação prefill/decode com um backend de transferência de cache. Uma implantação de instância única não tem esse caminho. A lição geral — uma leitura corrompida num LLM aparece como texto fluente, não como erro — não depende de arquitetura.
O que deveria entrar no meu questionário de fornecedor agora? Motor e versão, se há serving desagregado em uso, se as verificações de integridade na transferência estão ligadas, e qual instrumentação detectaria contaminação entre requisições se ela acontecesse. A última é a pergunta que quase ninguém faz e a única que produz evidência.