Custos de IA · LLM · Engenharia
Preço de LLM caiu e sua conta não: o corte foi no cache
O preço da inferência caiu até 80% em 2026 e a sua fatura de IA não se mexeu. O corte foi para a leitura de cache, coluna que ninguém compara.
O preço da inferência de IA caiu até 80% neste ano. A sua fatura — que chega em dólar, todo mês, para qualquer time brasileiro que colocou IA em produção — provavelmente não caiu nada. As duas coisas são verdade, e o motivo está em uma coluna da tabela de preços que quase ninguém lê: a leitura de cache. Em um produto agêntico — qualquer coisa que roda em loop, carrega um código inteiro no contexto ou sustenta uma conversa por vários turnos — é o preço da leitura de cache, e não o preço de entrada e saída estampado na capa, que governa a maior parte da conta. A guerra de preços de 2026 foi travada quase inteiramente nessa coluna.
A consequência é direta: a tabela pública ranqueia os modelos errado para a carga de trabalho que você realmente roda. E se você capturou ou não o desconto deste ano foi decidido pela arquitetura de prompt que você subiu meses atrás, não pelo anúncio que você leu semana passada.
Dois tipos de número neste post
Todo preço citado aqui vem da tabela publicada pelo próprio fornecedor, capturada em 26 de outubro de 2026, e toda razão entre eles foi calculada por nós a partir dessas tabelas. Os prints estão no texto para você conferir a conta.
Os percentuais de economia são outra categoria de afirmação. "Custa 40% menos em cargas típicas", "as contas típicas caem cerca de 25%", "o custo da inteligência do Fable caiu 54%" — cada um desses é uma empresa divulgando um número sobre o próprio produto, a partir das próprias cargas, sem reprodução independente. Citamos e marcamos todos, e não apoiamos o argumento neles. Onde o argumento precisa de um número medido, ele usa preço publicado ou avaliador independente.
Exatamente um número mudou
Claude Fable 5 e Claude Fable 5.1 têm preço idêntico em todas as linhas que um comprador normalmente compara: US$ 10 por milhão de tokens de entrada, US$ 50 de saída, US$ 12,50 na escrita de cache de cinco minutos, US$ 20 na de uma hora. A única célula diferente na tabela da Anthropic é "Hits and refreshes" — US$ 1 por milhão no Fable 5, US$ 0,25 no Fable 5.1. Corte de 75%, com o preço de capa intacto até o centavo.
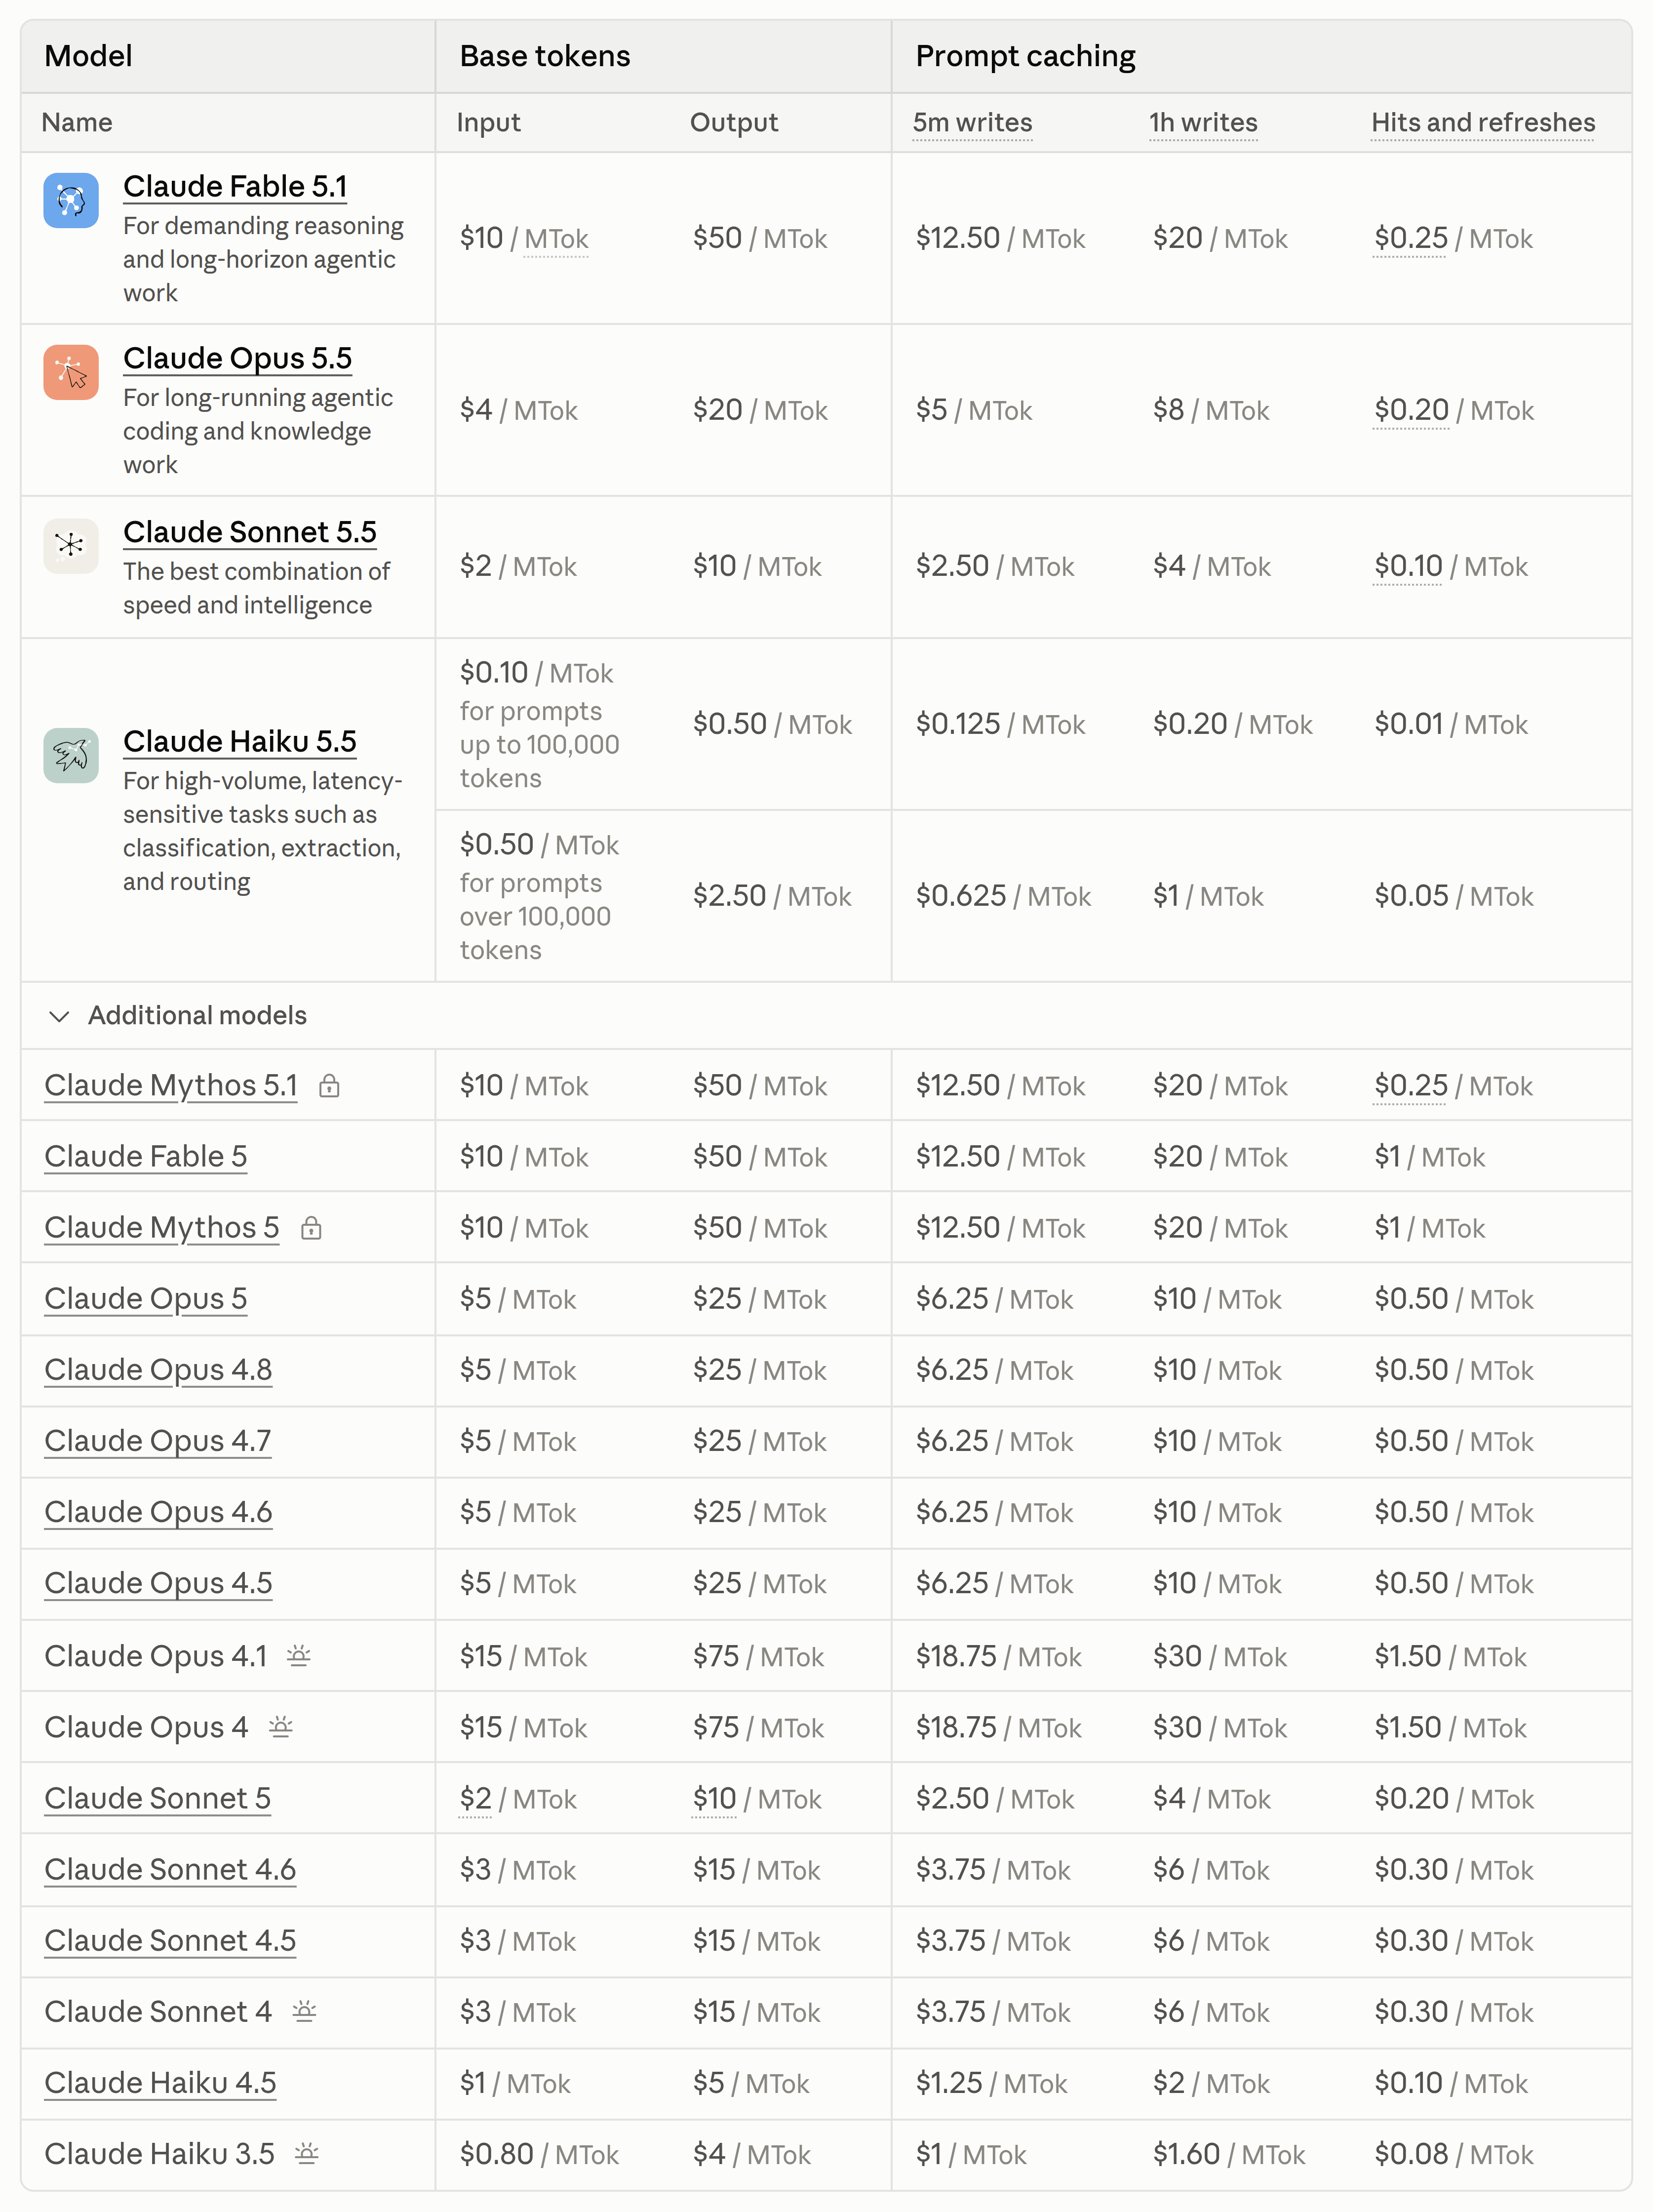
Suba uma linha na tabela e o ranking começa a balançar. O Fable 5.1 custa 2,5x o Opus 5.5 na entrada (US$ 10 contra US$ 4), mas apenas 1,25x na leitura de cache (US$ 0,25 contra US$ 0,20). O prêmio que o comprador lê na página é aproximadamente o dobro do prêmio que o agente de fato paga. Uma tabela, dois rankings defensáveis, dependendo da coluna em que a sua carga mora.
E a proporção não é uma constante para decorar. O preço do hit de cache como fração do preço de entrada dá 2,5% no Fable 5.1, 5% no Opus 5.5 e no Sonnet 5.5, 10% no Haiku 5.5 — e 10% no Fable 5, agora substituído. A profundidade do desconto de cache é uma decisão por modelo, refeita a cada lançamento.
O próprio fornecedor explica o mecanismo
Isso não é leitura nas entrelinhas. O anúncio do Opus 5.5 da própria Anthropic diz que as leituras de cache "representam a maior parte do custo de trabalho agêntico e de programação", cobra US$ 0,20 por milhão e chama isso de 60% menos que o Opus 5. Entrada e saída, no mesmo parágrafo, caíram 20%.
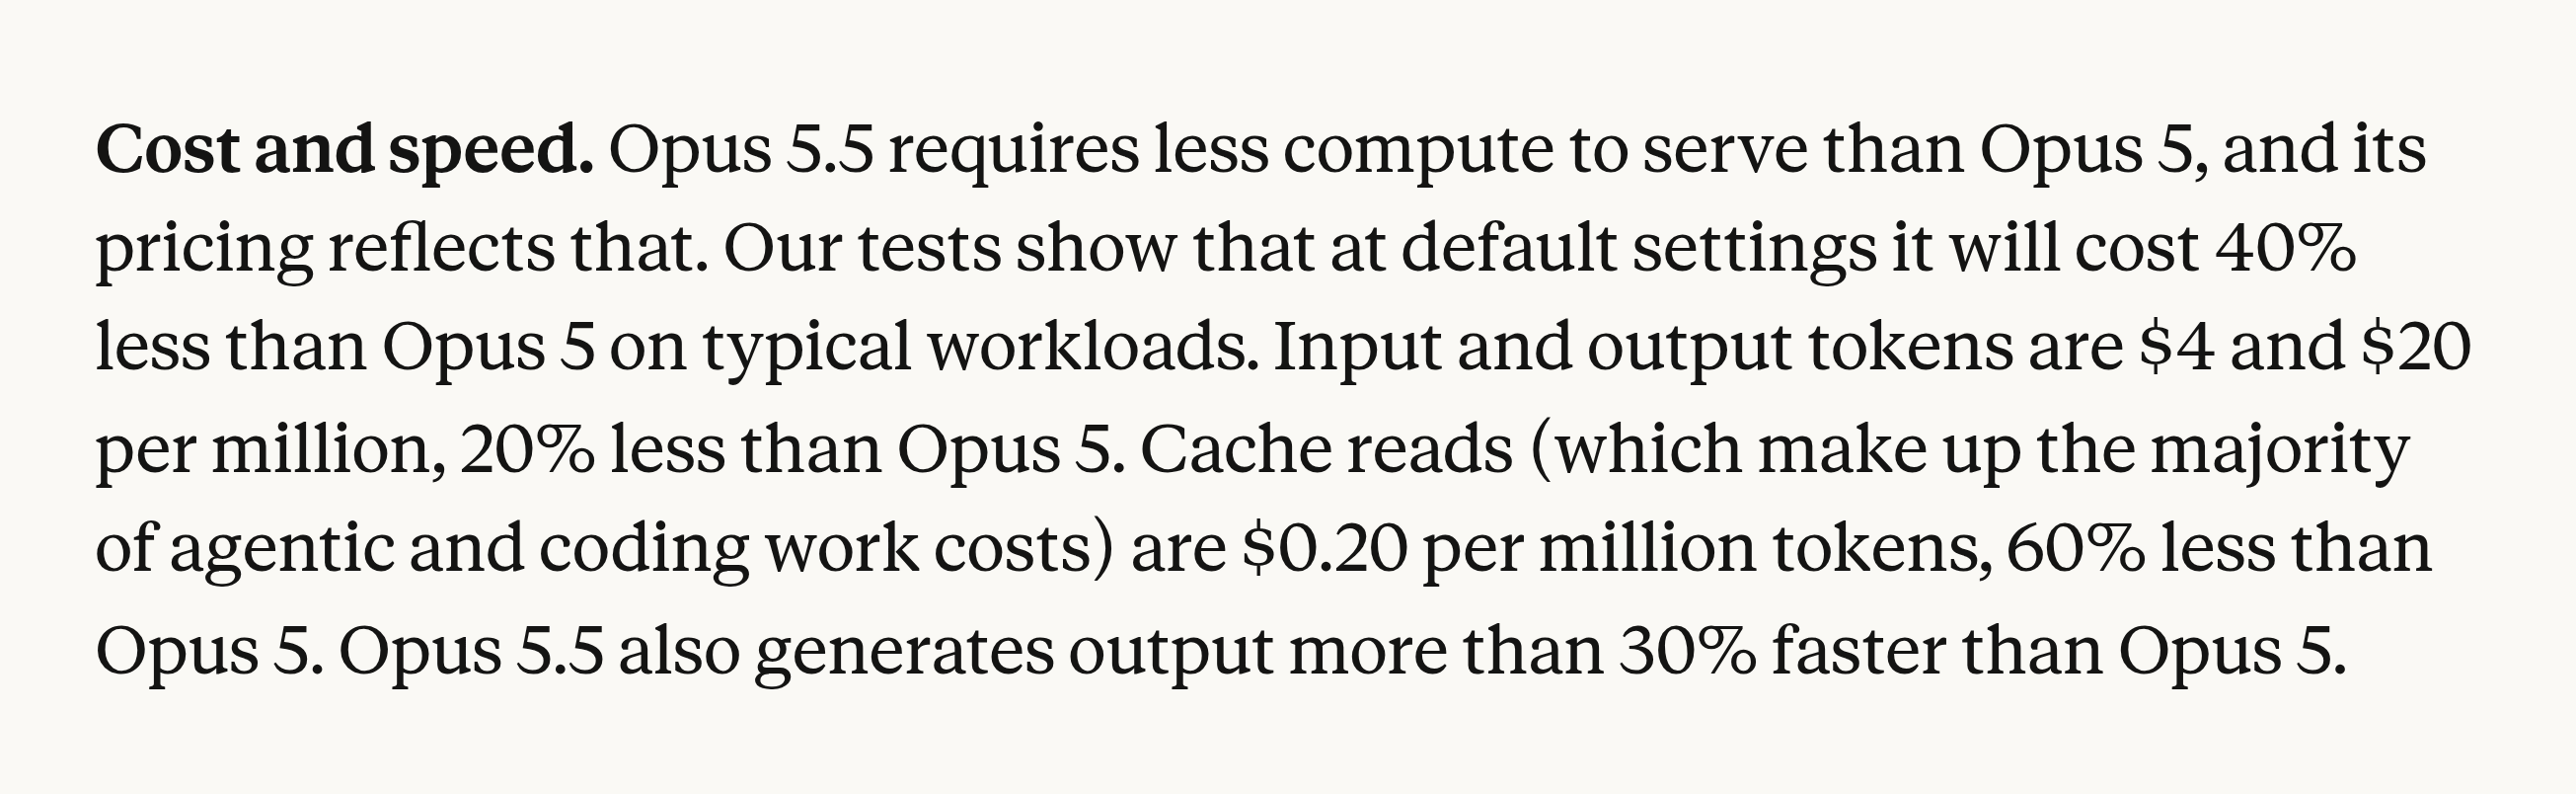
O corte é três vezes mais profundo na coluna que ninguém cita do que na coluna que virou manchete.
Para onde vai o dinheiro de um agente
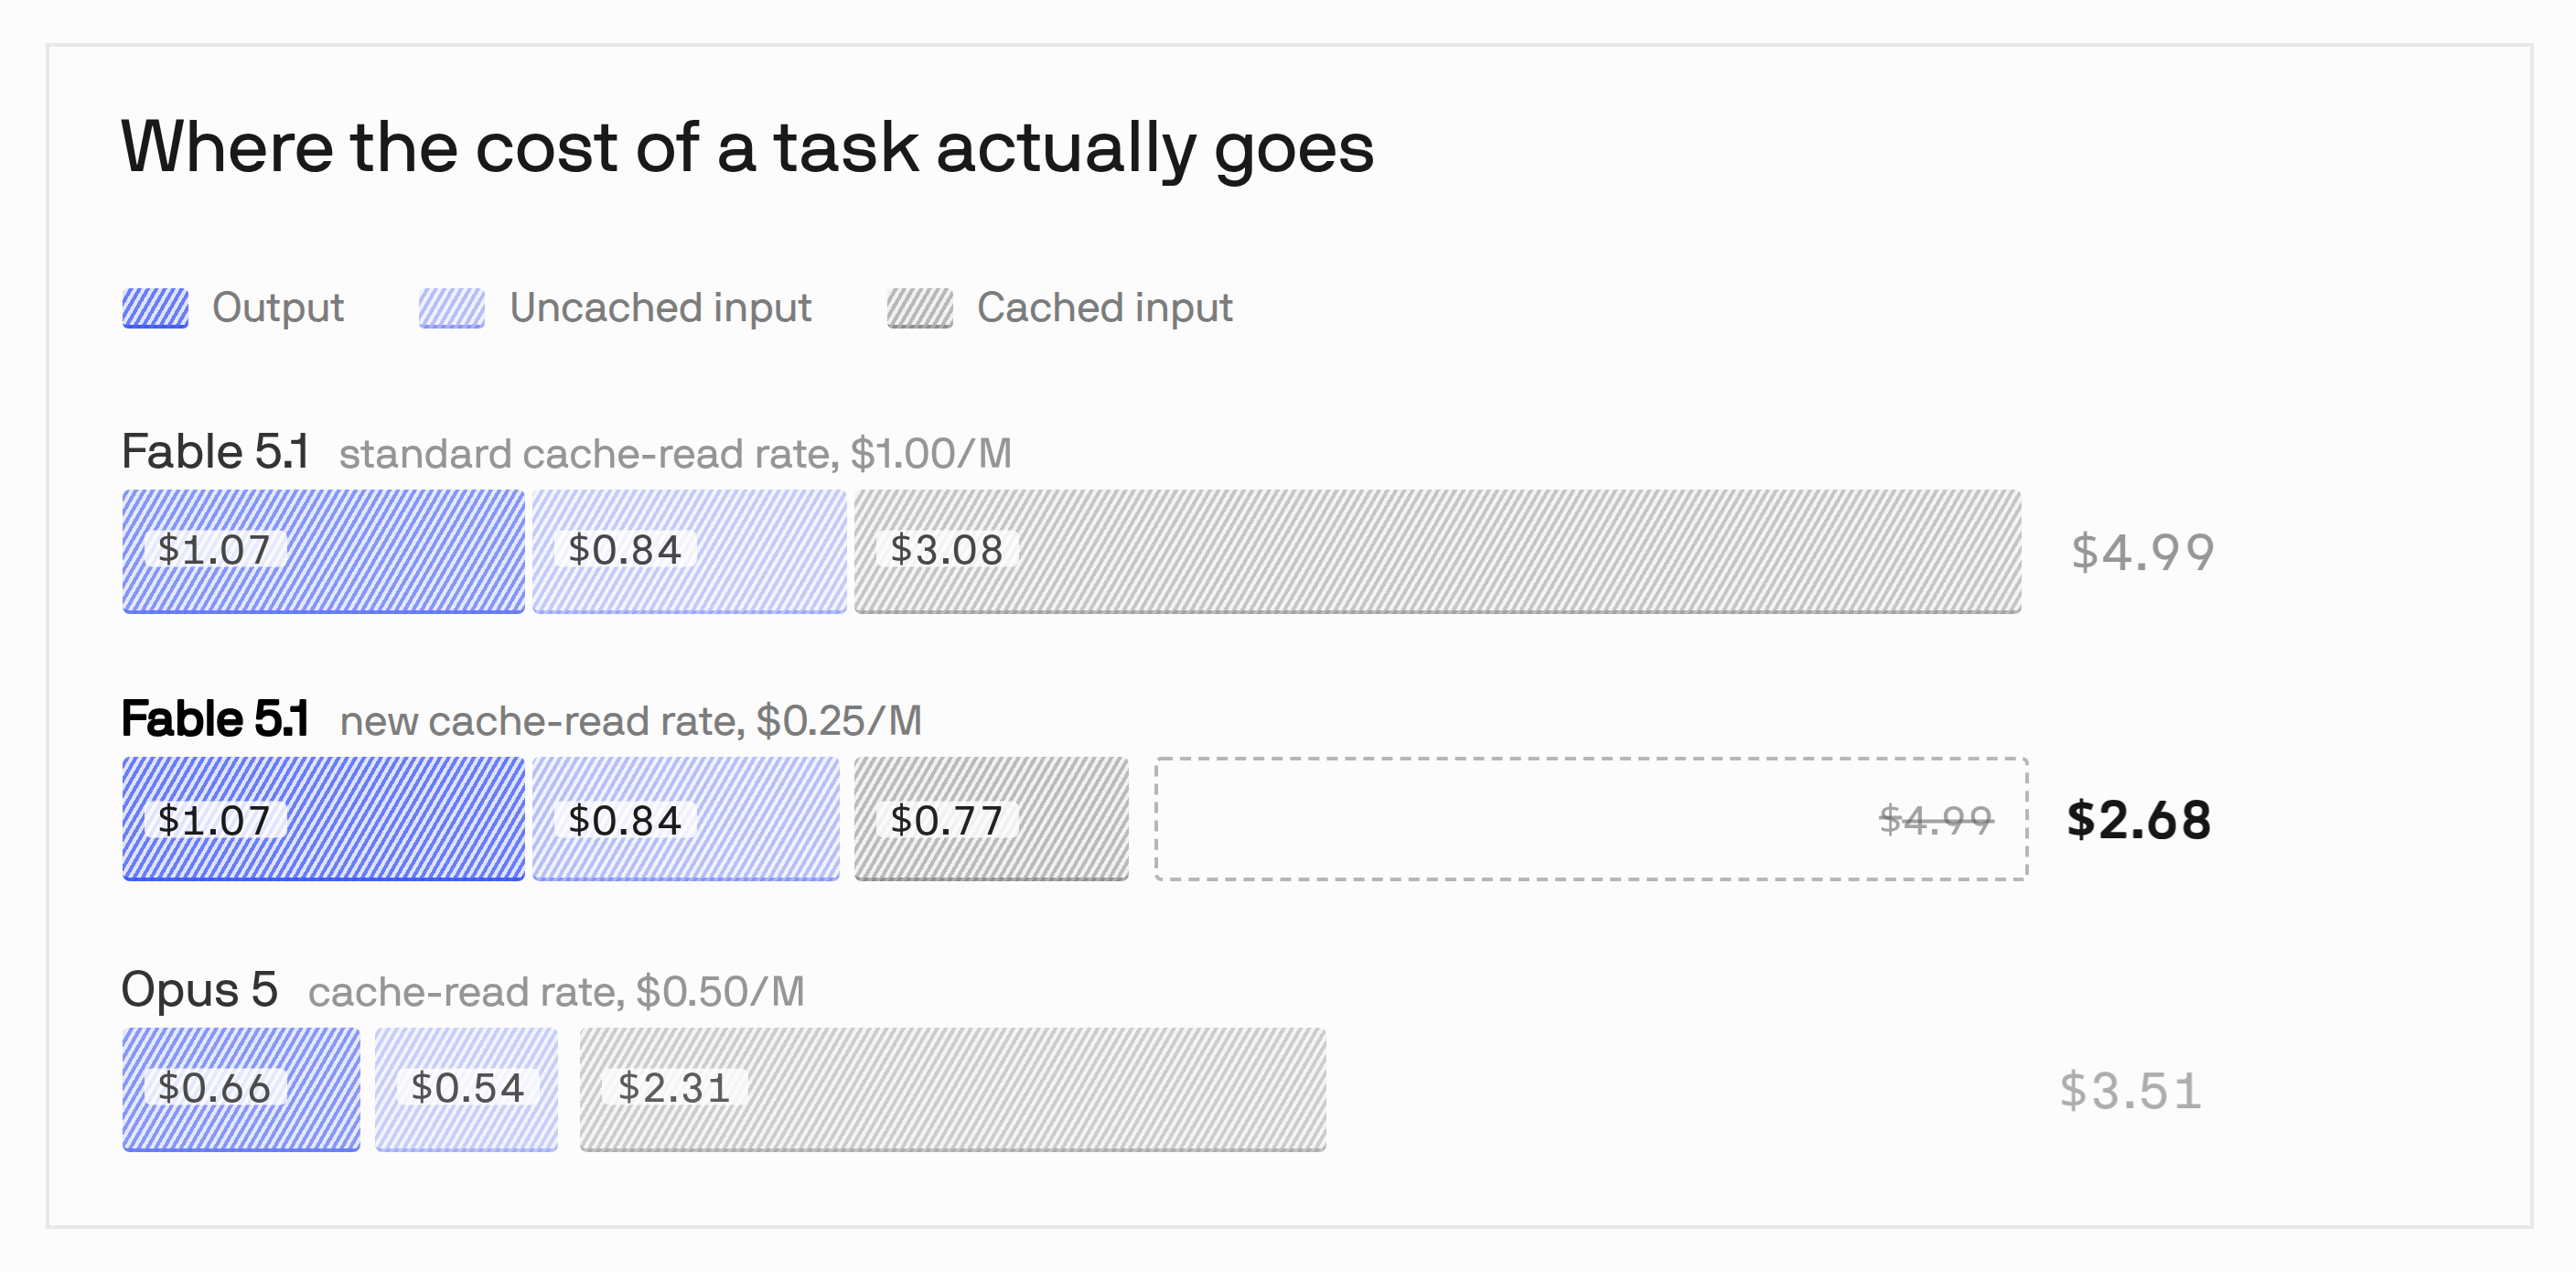
A Cognition publicou a decomposição de uma única tarefa de código no próprio benchmark: saída US$ 1,07, entrada não cacheada US$ 0,84, entrada cacheada US$ 3,08 — US$ 4,99 no total, à taxa antiga de US$ 1,00 por milhão de leitura de cache. A entrada cacheada é 62% dessa conta. As duas colunas que a página de preços anuncia respondem por 38%. A composição de tokens por trás disso é de ~3 milhões de tokens cacheados contra cerca de 21 mil de saída e 70 mil de entrada não cacheada, que eles resumem como "mais de 95% dos tokens nos dois modelos são leituras de cache".
A Cognition vende um agente construído sobre esses modelos, então leia os percentuais de economia deles como afirmação de fornecedor sobre si mesmo. O que se sustenta é a estrutura de custo, porque a Anthropic afirma o mesmo de forma independente e a proporção é reproduzível a partir dos preços publicados.
Agora a multa por errar. No Opus 5.5, uma escrita de cache de cinco minutos custa US$ 5 por milhão contra US$ 0,20 do hit — 25x para reenviar um contexto que o modelo já tem. Até a entrada não cacheada comum custa 20x o preço do hit. Um prompt que quebra o cache a cada turno — um timestamp no topo do system prompt, uma lista de ferramentas que muda de ordem, um histórico reconstruído em vez de acrescentado — paga esse múltiplo em todos os turnos, em silêncio, e nenhum log seu chama isso de erro.
Quebrar o cache não é um problema de performance. É um evento de cobrança.
A mesma conta, a resposta oposta
Rode o mesmo raciocínio na OpenAI e ele aponta para o outro lado. A tabela publicada lista o gpt-6-astra a US$ 10,00 de entrada / US$ 50,00 de saída / US$ 1,00 de entrada cacheada, e o gpt-6.1-sol a US$ 2,00 / US$ 10,00 / US$ 0,10. O Astra custa 5x o Sol no número que você lê e 10x no número que uma carga dominada por cache efetivamente paga.
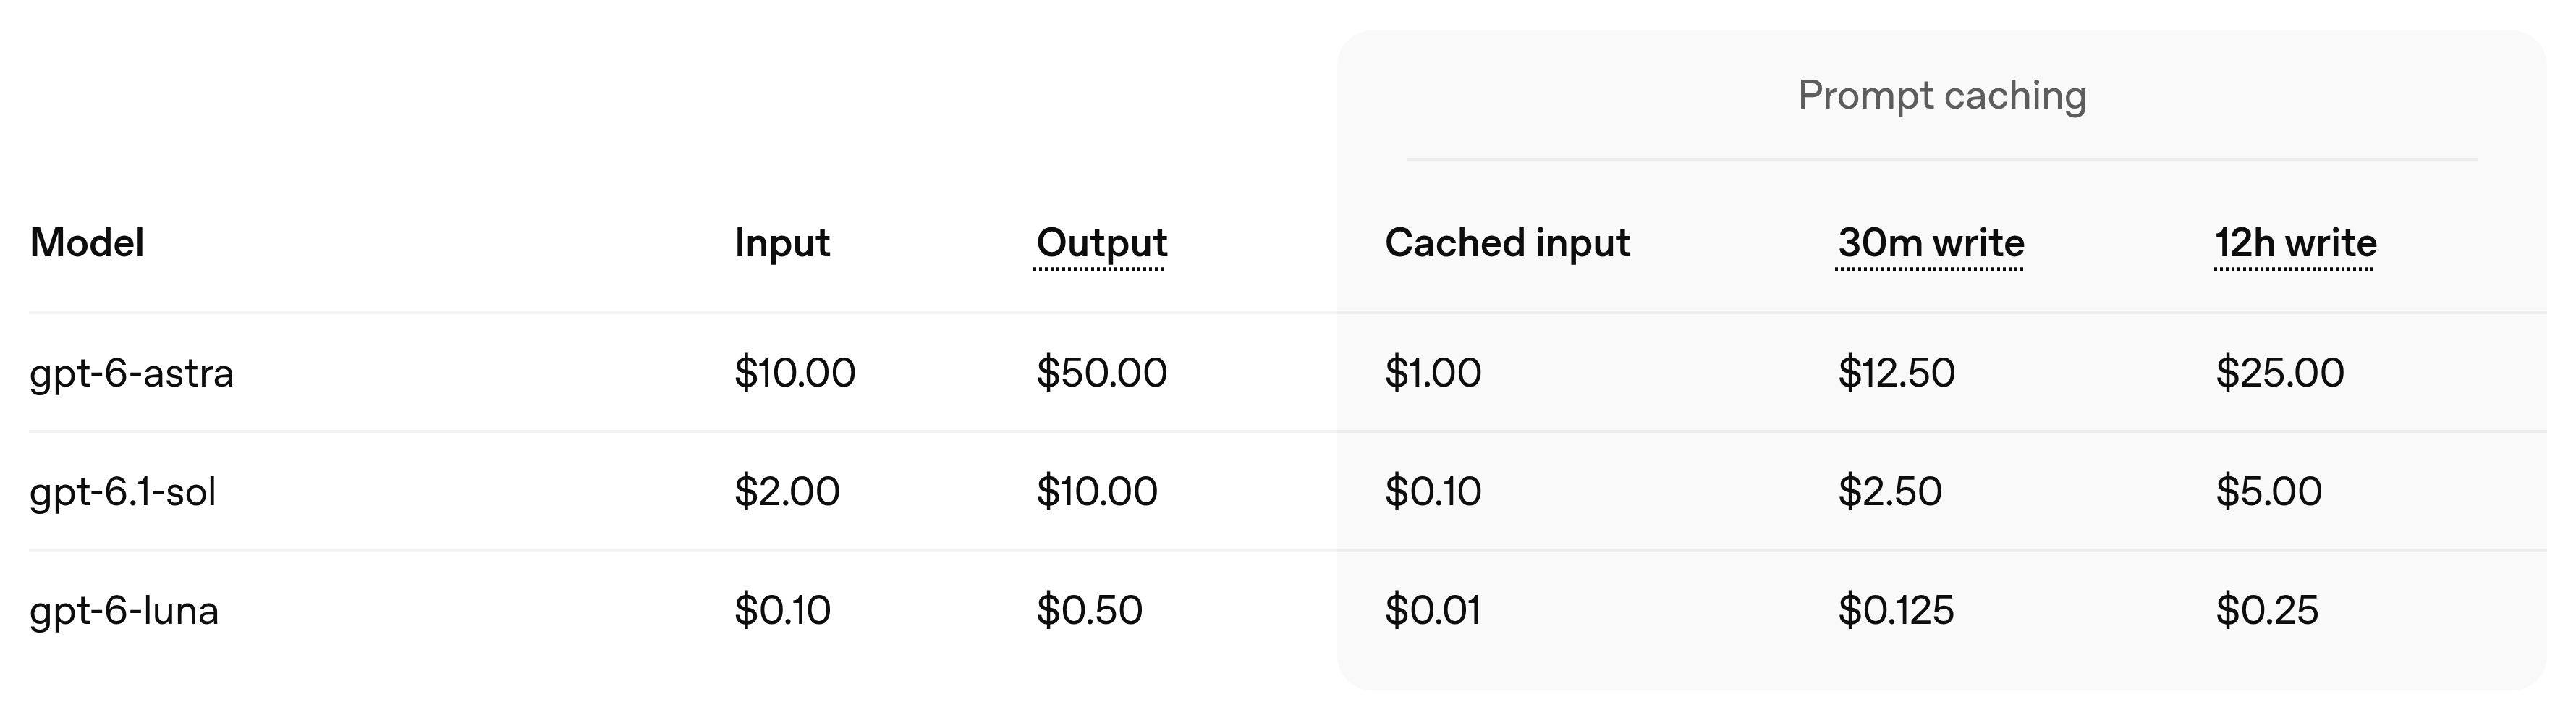
Ou seja, a correção inverte. O mesmo raciocínio que torna o modelo mais caro da Anthropic mais barato do que parece para trabalho agêntico torna o modelo mais caro da OpenAI mais caro do que parece. Dois fornecedores, a mesma estrutura de preço, correções opostas — o que significa que não existe regra de bolso para levar de um para o outro. Existe a conta, modelo a modelo, contra a sua composição de tokens.
Corte de preço não é corte de conta
A Artificial Analysis mediu o Fable 5.1 a US$ 3,76 por tarefa do Intelligence Index em esforço máximo, contra US$ 3,14 do Fable 5. São 20% a mais por tarefa, no mesmo lançamento que trouxe o corte de 75% na leitura de cache, porque o modelo novo emite cerca de 1,7x mais tokens de saída.
A Artificial Analysis declara na mesma página que fez avaliação pré-lançamento para a Anthropic — o que vale saber, e o que torna o achado mais interessante, não menos, já que ele contraria o marketing do fornecedor.
Preço por token e custo por tarefa são grandezas diferentes, e um único lançamento pode movê-las em direções opostas. Só uma das duas aparece na sua fatura.
O que fazer antes do próximo anúncio
- Instrumente a taxa de cache hit. Os dois fornecedores devolvem a contagem de tokens cacheados no payload de uso de cada resposta. Se você não sabe dizer hoje que fração da sua entrada é leitura de cache, você não consegue projetar o seu gasto com IA — e nenhuma página de preços vai te contar.
- Projete pela sua composição de tokens, não pela tabela. Multiplique a composição medida por cada coluna, modelo a modelo. Esse número, e não o preço de capa, é o que uma troca de modelo custa.
- Trate a estrutura do prompt como controle de custo. Prefixo estável, histórico só acrescentado, nada volátil acima do ponto de cache. É uma decisão de arquitetura com multiplicador de 25x anexado, o que a tira da gaveta de "detalhe de prompt engineering" onde ela costuma ficar.
- Refaça o ranking por carga quando o preço mudar. Um corte que cai na coluna de cache vale muito para quem tem contexto reutilizável longo e não vale absolutamente nada para quem faz classificação de uma tacada só.
Esse é o trabalho que fazemos quando levamos software feito com IA para produção na SV Dev: a revisão de custo acontece antes da escolha do modelo, não depois da primeira fatura surpreendente. É a mesma classe de problema de fixar a versão do modelo e de conter código escrito por IA — uma decisão que parece detalhe de implementação na hora do commit e vira linha de resultado dois trimestres depois.
Pontos principais
- Os cortes de preço de LLM em 2026 caíram majoritariamente na leitura de cache, coluna que o preço de capa nunca cita.
- Fable 5 e Fable 5.1 têm preço de capa idêntico; só o preço de leitura de cache mudou, em 75%.
- O ranking por capa e o ranking por cache discordam — e discordam em direções opostas na Anthropic e na OpenAI.
- Um cache miss no Opus 5.5 custa até 25x um cache hit, cobrado em todo turno.
- Um corte de 75% ainda pode produzir conta maior se o modelo emitir mais tokens de saída.
Perguntas frequentes
O que é leitura de cache e por que ela domina o custo agêntico?
Quando o modelo relê um contexto que já processou — system prompt, schema de ferramentas, base de código, turnos anteriores da conversa —, esse contexto pode ser servido de um cache de prompt com desconto alto, em vez de ser reingerido a preço cheio de entrada. Agentes releem volumes enormes de contexto estável a cada turno, então as leituras de cache viram a maior parte dos tokens e, junto com eles, a maior parte da conta.
Por que minha conta de IA não caiu mesmo com os preços caindo?
Provavelmente por um destes três motivos: a sua carga tem pouco contexto reutilizável, então o desconto de cache não se aplica a você; os seus prompts invalidam o cache a cada turno, e você paga escrita ou entrada cheia repetidamente; ou você migrou para um modelo novo que produz mais tokens de saída por tarefa, o que pode anular o corte na leitura de cache.
O modelo mais caro é sempre a escolha errada para agentes?
Não, e é exatamente esse o ponto. Na tabela da Anthropic o prêmio do modelo de topo cai pela metade quando você o precifica por leitura de cache; na da OpenAI ele praticamente dobra. O ranking depende do fornecedor e da sua composição de tokens, então precisa ser calculado, não presumido.
Como medir isso sem ferramenta nova?
Leia o objeto de uso que você já recebe em cada resposta da API. Some tokens de entrada cacheados, não cacheados e de saída por tarefa ao longo de uma semana e multiplique os três totais pelos três preços de cada modelo candidato. O método é esse.